gerade bei TechTV vom MIT gefunden: ein Video über die Transkription, also das Abschreiben eines Gens in mRNA - mit LEGO!
[via BoingBoing Gadgets]
Posts mit dem Label Molekularbio werden angezeigt. Alle Posts anzeigen
Posts mit dem Label Molekularbio werden angezeigt. Alle Posts anzeigen
Dienstag, März 03, 2009

Montag, März 02, 2009
Projekt Paperübersicht Intermezzo: Homologe Rekombination
 Während es im letzten Post um den Reparatur-Aspekt unserer Mutanten ging, soll im nächsten deren Beteiligung an der DNA-Rekombination betrachtet werden. Doch das wird ohne ein wenig Hintergrundwissen zur homologen Rekombination nicht so leicht werden, deshalb habe ich mich für diesen hoffentlich nicht zu komplexen Einschub entschieden.
Rekombination bedeutet zunächst, dass genetische Information zwischen zwei DNA-Molekülen ausgetauscht wird. Von den vielen Rekombinationsmechanismen ist die homologe Rekombination der konservativste. Das war jetzt keine politische Aussage, es bedeutet nur, dass es dabei idealerweise zu keiner Änderung der Sequenz kommt. Dies ist möglich, weil für die homologe Rekombination identische (= homologe) DNA-Sequenzen verwendet werden. Diese Sequenzen kommen bei diploiden Organismen wie dem Menschen oder Arabidopsis vom homologen Chromosom. Oder, noch besser, nach der Verdopplung der Chromosomen während der Replikation, vom Schwesterchromatid. Ausgangspunkt der homologen Rekombination ist immer ein Doppelstrangbruch. Dieser kann gewollt sein, etwa in der Meiose (dazu in einem anderen Teil der Paperübersicht mehr, wahrscheinlich #5). Alternativ kann ein Doppelstrangbruch aber auch durch ionisierende Strahlung oder Chemikalien ausgelöst werden. Dies wäre dann die Verbindung der homologen Rekombination mit der DNA-Reparatur.
Was wirklich während der homologen Rekombination passiert, wissen wir noch nicht hundertprozentig. Man kann diesen vorgang nicht live an einem DNA-Molekül mitverfolgen. Man kann aber seine Versuche so aufbauen, dass bestimmte Abläufe aufgrund des Ergebnisses ausgeschlossen werden können, andere Abläufe aber wahrscheinlicher werden. Viele solcher grundlegenden Experimente wurden mit der Bäckerhefe Saccharomyces cerevisiae gemacht, bei der clever definierte Konstrukte in das Genom eingebracht wurden, die nach einer homologen Rekombination erlauben, Anteile von bestimmten Vorgängen zu ermitteln. Das hört sich jetzt sehr nichtssagend an, deshalb will ich kurz an einem schönen Beispiel zeigen was ich damit meine.
Das "Double Strand Break Repair" Modell der homologen Rekombination
1983 fassten Szostak et al. in einem Review-Artikel den damals aktuellen Stand der Rekombinationsforschung zusammen. Dabei stellten sie fest, dass bisher vorgeschlagene Modelle der homologen Rekombination selten auftrende Ereignisse während der Meiose nicht vorhersagen konnten. Wenn man beispielsweise zwei Marker betrachtet [1], die heterozygot und gekoppelt vorliegen (also gemeinsam auf einem Chromosom sitzen, aber nicht auf dem zweiten Chromosom eines diploiden Organismus), dann erwartet man in den Nachkommen die einfache Aufspaltung nach Mendel in 1:1 - eine Hälfte der Nachkommen hat das Chromosom mit beiden Markern erhalten, die andere Hälfte das homologe Chromosom ohne die Marker. Aufgrund der besonderen Chromosomensituation der damals untersuchten Pilzarten ist die Notation hier traditionellerweise nicht 1:1, sondern 4:4, das ändert am Verhältnis aber nichts. Man kann nun aber beobachten, dass manchmal auch andere Aufteilungen passieren, beispielsweise 6:2 (bzw. 2:6), oder auch 5:3. Hier muss Information von einem Chromosom auf ein anderes übertragen worden sein, oder ein Austausch zwischen zwei Chromosomen erfolgt sein, so dass die beiden Marker nicht mehr gekoppelt auf einem Chromosom vorliegen und unabhängig voneinander vererbt werden können. Diese beiden Vorgänge bezeichnet man als gene conversion und crossing over, und sie sind in Abbildung 1 aus Szostak et al. dargestellt (wenn auch in umgekehrter Reihenfolge):

Abbildung 1 aus Szostak et al. (1983). Zustand von zwei gekoppelten heterozygoten Markern A und B und die Effekte von crossing over (a) und gene conversion (b). Klicken für größere Version.
Woran liegt das nun? Szostak et al. schlagen einen Mechanismus vor, der auf der Reparatur von Doppelstrangbrüchen beruht. Dies war neu, denn die bisherigen Modelle gingen von Auslösern wie kurzen einzelsträngigen Bereichen auf der DNA (ssDNA nicks) aus. Von der Reparaturforschung war damals bereits bekannt, dass die Doppelstrangbruchreparatur in der Bäckerhefe sehr effizient ablief. Das neue Modell sollte also mit Doppelstrangbrüchen beginnen, und mit der Möglichkeit für sowohl crossing over, als auch gene conversion enden. Die Idee von Szostak und Kollegen sah folgendermaßen aus:

Doppelstrangbruchreparatur Modell (DSBR) nach Szostak et al. (1983). Klicken für größere Version.
Ausgehend von einem Doppelstrangbruch werden die freien Enden durch Proteine (Exonukleasen) so zurückgeschnitten, dass freie einzelsträngige Überhänge vorliegen. So eine ssDNA ist dann natürlich verfügbar für Basenpaarungen. Wenn nach einer "Homologiesuche" eine homologe DNA-Sequenz gefunden wird (die wie gesagt beispielsweise auf dem homologen Chromosom, oder auch dem Schwesterchromatid liegen kann), dann erfolgt die sogenannte Einzelstranginvasion: Der Einzelstrang lagert sich an die komplementäre Sequenz an und verdrängt dabei einen der vorhandenen Stränge. Die daraus resultierende Struktur wird D-Loop (displacement loop) genannt. Von hier an kann das freie Ende mit Hilfe einer DNA-Polymerase verlängert werden, was den D-Loop vergrößert. Irgendwann ist ein so großer Bereich DNA im D-Loop verdrängt, dass dieser mit dem zweiten freien Ende des Doppelstrangbruches paaren kann. Dies bedeutet auch, dass das erste freie Ende endlich mit der anderen Seite des Doppelstrangbruches verknüpft werden kann. Der DSB ist jetzt zwar repariert, aber wir haben nun eine problematische DNA-Struktur vorliegen - zwei DNA-Moleküle sind an zwei Positionen überkreuzt. So eine kreuzförmige DNA-Struktur nennt man übrigens nach ihrem Erstbeschreiber Holliday Junction (AHA!), bei den zwei Überkreuzungen hier spricht man von einer doppelten Holliday Junction (dHJ). Warum ist diese Struktur problematisch? Weil eine Zelle sich nicht teilen kann, bevor die dHJ aufgelöst wurde!
Und jetzt greift die Idee von Jack Szostak und Kollegen. Eine Endonuklease, also ein Protein das im Inneren eines DNA-Moleküles schneidet, kann an den Holliday Junctions Schnitte setzen, um die zwei Stränge voneinander zu trennen. Und abhängig davon, ob die beiden Schnitte symmetrisch (unten links) oder asymmetrisch (unten rechts) erfolgen, erhält man entweder ein crossing over (CO, rechts) oder eine gene conversion (auch noncrossover genannt, also NCO, links).
Seit 1983 ist viel Zeit vergangen, doch das DSBR-Modell hat sich gehalten. Mittlerweile wurde etwa gezeigt, dass in der Meiose ein spezielles Protein absichtlich Doppelstrangbrüche zur Einleitung der homologen Rekombination setzt: SPO11. Auch Holliday Junctions wurden bereits als Intermediate der Rekombination experimentell nachgewiesen.
"Synthesis-dependent strand-annealing" und das "revised model"
Um es jetzt noch ein wenig komplizierter zu machen, will ich der Vollständigkeit halber das Bild auf den aktuellen Stand bringen. Als 1994 die Gruppen von William Engels und Gregory Gloor (Nassif et al., 1994) Rekombinationsexperimente mit der Fruchtfliege Drosophila melanogaster machten, stießen sie auf Ergebnisse, die sich mit dem DSBR-Modell von Szostak et al. nicht vollständig erklären ließen. Letzen Endes waren ihre Ergebnisse nur zu verstehen, wenn man beiden freien Enden des DSB erlaubte, unabhängig voneinander die Rekombination mit verschiedenen Partnern einzuleiten. Eine Auflösung nach ihrem synthesis-dependent strand-annealing-Modell (SDSA) benötigte demnach keine Holliday Junction als Intermediat. Bereits nach Verlängerung des ersten freien Endes würde dieses aus dem D-Loop geworfen und für die Basenpaarung mit dem zweiten Ende zur Verfügung stehen. Durch solch einen Mechanismus wären keine Crossoverprodukte möglich.
2001 wurden die beiden konkurrierenden Modelle DSBR und SDSA dann gleichzeitig von zwei Gruppen zusammengefasst. In dem heute als revised model bezeichneten Prozess nach in der Bäckerhefe gewonnenen Ergebnissen von Hunter und Kleckner (2001) und Allers und Lichten (2001) beginnt die homologe Rekombination zunächst, wie ich es schon für DSBR und SDSA beschrieben habe. Die Aufteilung in die beiden Arme CO und NCO erfolgt jedoch schon vor dem dHJ-Intermediat, nämlich auf Ebene des D-Loop. Von hier ab kann dann die Rekombination entweder zum NCO aufgelöst werden, per SDSA-Modell. Oder eben über die doppelte Holliday Junction zum CO, das nach diesem Modell das einzige Ergebnis des DSBR-Weges ist.

revised model der homologen Rekombination nach Hunter und Kleckner (2001) und Allers und Lichten (2001). Klicken für größere Version.
Auf diesem Stand möchte ich es dann auch belassen für heute. Worauf ich hier überhaupt nicht eingegangen bin, sind die vielen Proteine, die diese ganzen Wege bevölkern. Von manchen kennt man recht gut ihre Position im Schema und ihre dortige Aufgabe, von vielen anderen weiß man aber nur ungefähr, in welche Hälfte des Modells sie passen.
Im nächsten richtigen Post dieser kurzen Serie werde ich dann, bewaffnet mit dem Hintergrund zur homologen Rekombination hier, Untersuchungen unserer Mutanten zur Rekombinationsrate vorstellen.
[1] Vor der Zeit der schnellen Sequenzierung, und auch vor dem Triumphzug der PCR waren solche Marker oft Sporenfarbgene der untersuchten Pilze, oder Antibiotika-Resistenzgene.
JW Szostak, TL Orr-Weaver, RJ Rothstein, FW Stahl (1983). The double-strand-break repair model for recombination Cell, 33 (1), 25-35 DOI: 10.1016/0092-8674(83)90331-8
N Nassif, J Penney, S Pal, WR Engels, GB Gloor (1994). Efficient copying of nonhomologous sequences from ectopic sites via P-element-induced gap repair. Mol Cell Biol., 14 (3), 1613-1625
Neil Hunter, Nancy Kleckner (2001). The Single-End InvasionAn Asymmetric Intermediate at the Double-Strand Break to Double-Holliday Junction Transition of Meiotic Recombination Cell, 106 (1), 59-70 DOI: 10.1016/S0092-8674(01)00430-5
T Allers, M Lichten (2001). Intermediates of Yeast Meiotic Recombination Contain Heteroduplex DNA Molecular Cell, 8 (1), 225-231 DOI: 10.1016/S1097-2765(01)00280-5
Montag, Februar 23, 2009
neues Blog: Labtutorials in Biology
Nur ein kurzer Hinweis auf ein neues interessantes Blog von Bálint L. Bálint, Labtutorials in Biology. Darin möchte er grundlegende Materialien, Geräte und Methoden aus der Molekularbiologie vorstellen, so dass beispielsweise Studenten ihre Benutzung lernen.
Spannend ist beispielsweise der Post "Liquid handling with pipettes", in dem er mit vielen (auch eigenen) Bildern und Videos das Funktionsprinzip von Pipetten erklärt, die große Vielfalt der verschiedenen Typen von Pipetten - von der Einmalpipette aus Plastik bis zum Pipettierroboter - zeigt, und auf ihren Einsatz im Labor eingeht.
Den Post sollten sich vielleicht mal die vielen Kriminallabor-Techniker aus dem Fernsehen gründlich antun, dass ich nicht mehr diese chronischen Wunden auf dem Unterarm habe [1].
[via ScienceRoll]
[1] Vom ständigen Reinbeißen, um nicht laut aufschreien zu müssen angesichts dem regelmäßigen Schrotten von teuren Pipetten.
Sonntag, Februar 15, 2009
Alles Gute nachträglich, Charles!
Leider stand letzte Woche soviel anderes Zeug an, dass ich keine Zeit für einen Post an Charles Darwins Geburtstag hatte. Anstatt jetzt nachträglich über einen Mann zu schreiben, über den in den letzten Wochen bereits so unheimlich viel geschrieben wurde, dass es des meisten wohl zum Hals raushängt [1], will ich kurz über ein Ereignis berichten, das letzten Donnerstag pünktlich zum Darwin Day stattfand.
Das Max-Planck-Institut für evolutionäre Anthropologie in Leipzig hat in einer Pressemeldung (Streaming-Video) die Entwurfsequenz des Neanderthalergenoms bekannt gegeben. Das ist erstmal ein wenig bedenklich, denn das Ankündigen von Ergebnissen in der Presse vor einer vollwertigen Publikation in einem peer review-Journal ist kein vorbildliches Handeln für einen Wissenschaftler. Hier kann man aber zumindest ein Auge zudrücken, denke ich - der Termin an Darwins Geburtstag war einfach zu verlockend, außerdem erfolgte die Pressekonferenz simultan auch auf dem Jahrestreffen der American Association for the Advancement of Science (AAAS), die unter anderm das Science Magazine herausgibt. Trotzdem, ein komisches Gefühl in der Magengegend bleibt.
Davon mal abgesehen ist das Ganze natürlich sehr spannend. Erst vor drei Jahren kündigte Svante Pääbo von der Abteilung Evolutionäre Genetik des MPIs an, das Neanderthalergenom sequenzieren zu wollen. Dies ist nur deshalb in so kurzer Zeit möglich (zur Erinnerung: die Arbeiten für das Humangenomprojekt in den 90ern dauerten rund 10 Jahre), weil mittlerweile neue, schnellere Sequenziermethoden zur Verfügung stehen. Diese sog. Sequenziertechnologien der zweiten Generation leiden aber alle an dem Problem, dass sie nur sehr kurze Sequenzstücke (20-50 Basenpaare) produzieren. Und hier hilft dann die harte Vorarbeit des Humangenomprojekts, denn mit dem menschlichen Referenzgenom lässt sich das Neanderthalergenom auch mit sehr kurzen Sequenzen zusammensetzen. Man erwartet nur sehr wenige Unterschiede zwischen den zwei Genomsequenzen, die Genome von Mensch und Schimpanse sind schließlich schon sehr ähnlich.
Um an Neanderthalersequenzen zu kommen, müssen jedoch erstmal mehrere Probleme vermieden werden. Verunreinigungen der Proben mit menschlicher DNA der beteiligten Forscher wären fatal, deshalb mussten die Neanderthaler-Proben in Reinraumbedingungen bearbeitet werden. Trotzdem lagen die Knochen sehr, sehr lange im Boden rum, die Proben enthalten darum jede Menge mikrobiolle DNA. Die wurde natürlich zunächst mitsequenziert, konnte aber dank bioinformatischer Methoden wieder entfernt werden: Bakterielle Genome sind im Vergleich mit dem menschlichen sehr klein, und es wurden bereits viele sequenziert. Indem die Leipziger Forscher ihre Sequenzen mit bakteriellen Genomsequenzen verglichen, konnten sie Verunreinigungen in ihren Daten erkennen und diese dann verwerfen. Diese Verunreinigungen machen ca. 90% des sequenzierten Materials aus! Wenn man dann noch bedenkt, dass die Gruppe um Svante Pääbo bei der DNA-Isolierung wegen fehlerhafter Protokolle ca. 99% Verlust hatte, dann ist es schon erstaunlich, wie weit sie in der kurzen Zeit gekommen sind.
Es muss aber ausdrücklich betont werden, dass es sich bestenfalls um eine erste Entwurfsequenz handelt. Ungefähr 60% des Genoms sind sequenziert, das aber nur einmal. Um sich gegen methodische Fehler der Sequenzierungstechnologien zu schützen, sollte jedes Nukleotid in einer Genomsequenz aber mehrmal sequenziert werden (die menschliche Referenzsequenz hat übrigens 12x Abdeckung). Ein weiteres Problem sind Sequenzunterschiede zwischen Individuen einer Art. Um die Variabilität der Genomsequenz einer Art einschätzen zu können, sollten möglichst viele individuelle Sequenzen vorhanden sein. Dies ist beim menschlichen Genom gerade im Gange, etwa mit dem Personal Genome Project oder dem 1000 Genomes Project. Sogar das erste menschliche Referenzgenom stellt in Wirklichkeit eine Mischung aus den Sequenzen von zwölf anonymen Individuen dar. Demnächst soll aber auch die Sequenzierung weiterer Neanderthaler-Proben beginnen, so dass dieses Problem wohl irgendwann behoben sein sollte.
Ein großes Problem soll auch nicht ungenannt bleiben: Durch das große Alter der Proben ist die DNA stark fragmentiert; es ist darum sehr wahrscheinlich, dass wir nie die komplette Genomsequenz des Neanderthalers erhalten werden.
Trotzdem ist es bereits mit diesen ersten Daten möglich, interessanten Fragen über das Verhältnis von Homo sapiens und Homo neanderthalensis nachzugehen. In weiten Teilen Europas lebten beide Menschenarten für mehrere tausend Jahre nebeneinander. Kam es zu einer Hybridisierung, also zu gemeinsamen Nachkommen beider Arten? Hat der heutige Mensch vielleicht sogar Neanderthaler als Vorfahren? Die bisherigen Sequenzdaten (beruhend auf mitochondrialen Sequenzen und dem Y-Chromosom) deuten eher in Richtung Nein.
Die Ausprägung des Gens MC1R (Melanocortinrezeptor 1), das das Ausmaß der Hautpigmentierung beeinflusst, zeigte, dass es möglicherweise auch hellhäutige und rothaarige Neanderthaler gab (Lalueza-Fox C et al (2007), Science 318:1453-5).
Abschließen möchte ich diesen Post mit (ja, richtig geraten) - einem Podcast! Vor ungefähr zwei Jahren, also noch relativ früh im Neanderthalergenomprojekt, wurde Svante Pääbo zusammen mit Thomas Jarvie (von 454 Life Sciences, die die Sequenziertechnologie zur Verfügung stellen) im immer guten Futures in Biotech Podcast interviewt [MP3-Link]. Ich habe das Interview seitdem nicht mehr gehört, werde aber vielleicht noch mal reinhören. Mal sehen, wie Pääbos Pläne von vor zwei Jahren mit der tatsächlichen Entwicklung mithalten konnten.
[1] Die öffentliche Aufmerksamkeit, die Darwin und Evolution gerade genießen ist sicher richtig und gut, aber ich freu mich auf die nächsten, ruhigeren Wochen. Bis es im Spätjahr dann mit dem 150jährigen Jubiläum der Origin-Veröffentlichung wieder rundgeht.
Freitag, Februar 06, 2009
Kaffee kreiert Krebs?
Die wissenschaftliche Blogwelt ist in Aufruhr: ‘Although there’s no evidence at all of a link between caffeine and cancer, we’re putting two and two together and saying: caffeine can induce these changes and it has been shown that these changes are elevated in leukaemia patients,’ added Dr Cooke.Er leitet sich also aus dem Fehlen eines Beweises die Grundlage seiner Forschung und gleich auch noch das passende Ergebnis ab? Ich ruf da mal gleich beim Nobelpreiskomitee an...
Worauf die bloggenden Kollegen (mit Ausnahme von Neuroskeptic) in ihrer Aufregung aber gar nicht eingegangen sind, und Herr Cooke wohl "übersehen" hat: Die Verbindung Koffein und Genomstabilität ist bereits recht gut verstanden! Leider aber nicht so, wie es in dem Artikel dargestellt wird. Aber der Reihe nach.
Signalisierung von Schäden an der DNA
Ich bin in ein paar Posts schon auf die Reparatur von DNA-Schäden eingegangen, aber einen wichtigen Teil davon habe ich bisher unterschlagen. Denn bevor die Zelle wirklich die Schäden repariert, muss sie erst noch entscheiden, ob sich die Reparatur überhaupt lohnt. Denn bei zahlreichen Schäden besteht immer auch die Gefahr, dass sich Mutationen einschleichen. Und bevor sich dann Krebs entwickelt, opfert der Organismus lieber eine Zelle. Dieser programmierte Zelltod folgt einem strengen genetischen Programm und wird als Apoptose bezeichnet. Hat sich die Zelle entschieden, die Schäden doch zu reparieren, dann müssen zunächst die zahlreichen Reparaturproteine aktiviert werden. Außerdem sollte während der Reparatur der Zellzyklus angehalten werden. Es wäre nämlich sehr schlecht, wenn die Zelle mitten im Reparaturprozess anfängt, ihre DNA zu replizieren, oder sich zu teilen.
ATM und ATR
Eine zentrale Rolle bei all diesen Signalen spielen zwei verwandte Proteine, die beim Menschen ATM und ATR heißen. Beide sind Kinasen, also Enzyme, die die Aktivität anderer Proteine regulieren, indem sie Phosphatgruppen auf bestimmte Aminosäuren übertragen. Im Fall von ATM und ATR ist diese Kinaseaktivität nun abhängig von verschiedenen Schäden an der DNA: Dadurch werden sie aktiviert, und übertragen Phosphate auf Proteine, die die oben angesprochenen Prozesse wie Apoptose, Zellzyklus oder Reparatur regulieren. Fallen ATM und ATR aus, führt dies beim Menschen zu Erbkrankheiten wie Ataxia-telangiectasia (ATM, versucht mal das mehrmals hintereinander zu sagen) oder Seckel Syndrom (ATR). Eigentlich sollte es nicht überraschen, dass Menschen, die an Ataxia-telangiectasia leiden, sehr strahlenempfindlich sind. Ionisierende Strahlung erzeugt schließlich DNA-Schäden, und durch den Ausfall von ATM funktioniert dann die Regulation von Reparatur etc. nicht mehr. Dieser Punkt ist aber noch aus einem anderen Grund wichtig, wie wir gleich sehen werden.

Abbildung des ATM-Signalweges in der Zelle aus dem GeneAssistTM Pathway Atlas von Ambion/Applied Biosystems. Gezeigt sind die wichtigsten Prozesse, die von ATM reguliert werden. Zielprotein werden von ATM aktiviert durch Anheften von Phosphatgruppen, dargestellt durch die Kreise mit "P" an den Proteinen.
Koffein hemmt ATM und ATR
Vor ein paar Jahren machten dann ein paar Forschergruppen eine interessante Entdeckung: Die Aktivität von ATM (und ATR) kann gehemmt werden durch Gabe von Koffein. Die Gruppe von Zhou et al. hat Glück, ihr im Journal of Biological Chemistry veröffentlichter Artikel darf für Lehrzwecke auch online frei benutzt werden. Durch Arbeiten mit Zellkulturen konnten sie zeigen, dass durch die Zugabe von Koffein mehrere von ATM aktivierte Signalketten unterdrückt wurden, beispielsweise ein Stopsignal im Zellzyklus, das die Einleitung der Zellteilung bei DNA-Schäden verhindern soll (der G2/M-Checkpoint). Dieser Effekt ahmt das Verhalten von A-T Zellen (Zellen von Patienten, die an Ataxia-telangiectasia leiden und in denen ATM inaktiv ist) nach, wie in Abbildung 5 des Artikels schön zu sehen ist.

Abb. 5 aus Zhou et al. (2000)
Chk2 ist ebenfalls eine Kinase, die aber hauptsächlich den Reparaturweg reguliert und von ATM aktiviert werden muss. Ohne jetzt groß das Prinzip hinter elektrophoretischen Methoden erklären zu wollen, sieht man nach Bestrahlung der Zellen die Aktivierung von Chk2 durch ATM in der höheren Bande bei 2 (vgl. mit 1), weil das Chk2-Molekül durch Anheften einer Phosphatgrupppe größer geworden ist. Diese Aktivierung findet nach Behandlung mit Koffein nicht mehr statt (die Bande ist bei 4 auf der gleichen Höhe wie die inaktive Kontrolle bei 1, es wurde also keine Phosphatgruppe drangehängt). Dieses Ergebnis ist vergleichbar mit dem Verhalten von A-T Zellen ohne Koffeinbehandlung (Nummern 5/6).
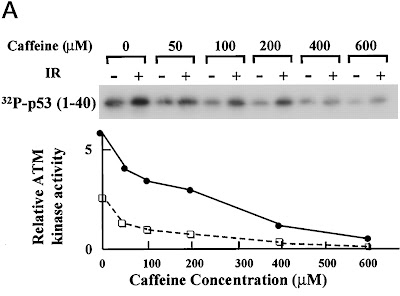
Abb. 7 aus Zhou et al. (2000)
In Abbildung 7 haben Zhou und Kollegen einen weiteren von ATM regulierten Weg angesehen, die Apoptose. Sehr wichtig zum Einleiten der Apoptose (dem programmierten Zelltod) ist das Protein p53, das ebenfalls durch Anheften einer Phosphatgruppe von ATM aktiviert werden kann. Wie man hier sehr schön sehen kann, wird p53 mit steigender Koffeinkonzentration immer weniger aktiviert, und das sogar ohne Bestrahlung (ausgeüllte Kreise: +Bestrahlung, offene Quadrate: -Bestrahlung)! Dies bedeutet, dass auch in wenigen Zellen, deren DNA nicht durch Bestrahlung massiv geschädigt wurde, spontane Schäden auftreten, die in einer Aktivierung von p53 (und wohl dem Auslösen der Apoptose) resultieren. Und Koffein kann das durch Hemmung von ATM unterdrücken.
Die medizinische Anwendung
Weiter oben habe ich bei der Beschreibung der Krankheit Ataxia-telangiectasia gesagt, dass die Patienten sehr strahlensensitiv sind, und die Daten hier haben auch gezeigt warum: ATM als zentraler Regulator von vielen zellulären Prozessen nach Schädigung der DNA kann diese Prozesse nicht mehr aktivieren, die Schäden werden nicht repariert und die Zellen versuchen munter, sich trotzdem zu teilen. Da Koffein dieses Erscheinungsbild von A-T Zellen nachahmen kann, wird es seit mehreren Jahren in der Krebsmedizin eingesetzt: Tumorzellen reagieren auf eine Strahlentherapie sensitiver, wenn der Patient zusätzlich Koffein verabreicht bekommt. Und dieser nützliche Effekt konnte auch für mehrere Chemotherapeutika gezeigt werden (etwa Cisplatin).
Nicht vergessen: die Konzentration!
Was in dem Daily Mirror-Artikel leider unterschlagen wird: Um diese Effekte von Koffein beim Menschen zu erreichen, sind Konzentrationen von etwa 10 mM nötig. Nach Trinken einer Tasse starken Kaffees liegt die Konzentration im Blut aber bei etwa 50 µM [1], sie ist also circa 200 mal niedriger. Anders ausgedrückt: Koffein ist nach maximal fünf Stunden im Blut wieder abgebaut, man müsste also mindestens 200 Tassen starken Kaffee innerhalb von weniger als fünf Stunden trinken, um einen Effekt von Koffein auf ATM zu erreichen!
Das Fazit der ganzen Geschichte: Der Daily Mirror sollte sich schämen, schwangeren Frauen Angst einzujagen, und Herr Cooke sollte vor seinem nächsten Projekt zumindest fünf Minuten recherchieren, mehr brauchts nämlich nicht. Und die Literatur ist wie gezeigt zumindest teilweise frei zugänglich.
[1] Berechnet aus einer Koffein-Plasmakonzentration von 10 mg/l und der Annahme von 8 mg/kg Koffein nach Genuss einer Tasse Kaffee.
[2] Sorry für den Titel, aber ich konnte es mir nicht verkneifen ;-)
Zhou, B. B., Chaturvedi, P., Spring, K., Scott, S. P., Johanson, R. A., Mishra, R., Mattern, M. R., Winkler, J. D., Khanna, K. K. (2000). Caffeine abolishes the mammalian G(2)/M DNA damage checkpoint by inhibiting ataxia-telangiectasia-mutated kinase activity J Biol Chem, 275 (14), 10342-10348
Mittwoch, Februar 04, 2009
Die geplatzte Blase
Ich meine nicht die aktuelle Finanzkrise, sondern den Boom und darauf folgenden Absturz der Biotechbranche Ende der 90er Jahre. Keith Robinson hat das bei einem der damaligen Biotech-Unternehmen Millennium Pharmaceuticals hautnah miterlebt, und hat vor ein paar Tagen auf Omics! Omics! ein wenig in Erinnerungen geschwelgt.
Auf den Punkt mit der Genzahl ist er dann in einem weiteren Post genauer eingeganen. Woher kamen die unheimlich großen Zahlen in den Schätzungen, wieviele Gene im menschlichen Genom zu finden sind, zu einer Zeit bevor die menschliche Genomsequenz veröffentlicht war? 50 000, 100 000, oder vielleicht sogar 200 000? Wohl hauptsächlich Konkurrenz. Wenn die Biotechfirmen A und B beide mit Bioinformatik und viel Fleiß an den Sequenziergeräten Datenbanken mit menschlichen Genen zusammenstellen und diese verkaufen wollen, etwa an Pharmafirmen, welche Datenbank wird dann eher gekauft? Solange man sich nur auf grobe Schätzungen verlassen kann vorsichtshalber die mit doppelt so viel Genen. So hat sich das dann langsam hochgeschaukelt in sehr luftige Höhen. Selber schuld, wenn alle mitspielen. Umso ernüchternder war für die Kunden dann das Resultat aus dem Human Genome Project: ca. 25 000 bis 30 000 Gene, die in den letzten Jahren dann auf eher 22 000 bis 23 000 zusammengeschrumpft sind.
Das soll aber nicht heißen, dass sich nicht ein paar Leute schon in den Neunzigern darüber Gedanken gemacht hätten:
Beide Artikel sind sehr lesenswert, und schon allein deshalb interessant, weil man über die jungen Jahre der Genomik meistens nur von der Seite der akademischen Forschung hört.
Of course, if you have a mountain of loot you probably want to protect it. Enter the lawyers. Millennium had always filed on their discoveries; now they had lots of discoveries to protect. But protect from what? Well, the paranoia was a loss of "Freedom to Operate", usually known as FTO. Nobody knew what would stand up as a patent -- but there were instructive examples from the early biotech era of business plans sunk by a loss of FTO -- and expensive lawsuits that clearly marked that loss. So the patenting engine took off -- an expensive insurance policy against an unpredictable future.
[...]
This was the late 90's and the hype was getting thick -- we were guilty but so were others. Millennium wasn't a big pusher of high gene counts -- at least in the terms of the day (but that's another whole story), but certainly we started selling all those genes we had & the ones we extrapolated were still out there. A key part of the business model was to sell the genes many times -- if we could sell the same gene to Lilly for cardiovascular & Roche for metabolic and AstraZeneca for inflammation, all the better. Not that anything underhanded went on; we'd present the case to each company & most of the deals had exclusivity only within a therapeutic area.
Auf den Punkt mit der Genzahl ist er dann in einem weiteren Post genauer eingeganen. Woher kamen die unheimlich großen Zahlen in den Schätzungen, wieviele Gene im menschlichen Genom zu finden sind, zu einer Zeit bevor die menschliche Genomsequenz veröffentlicht war? 50 000, 100 000, oder vielleicht sogar 200 000? Wohl hauptsächlich Konkurrenz. Wenn die Biotechfirmen A und B beide mit Bioinformatik und viel Fleiß an den Sequenziergeräten Datenbanken mit menschlichen Genen zusammenstellen und diese verkaufen wollen, etwa an Pharmafirmen, welche Datenbank wird dann eher gekauft? Solange man sich nur auf grobe Schätzungen verlassen kann vorsichtshalber die mit doppelt so viel Genen. So hat sich das dann langsam hochgeschaukelt in sehr luftige Höhen. Selber schuld, wenn alle mitspielen. Umso ernüchternder war für die Kunden dann das Resultat aus dem Human Genome Project: ca. 25 000 bis 30 000 Gene, die in den letzten Jahren dann auf eher 22 000 bis 23 000 zusammengeschrumpft sind.
Das soll aber nicht heißen, dass sich nicht ein paar Leute schon in den Neunzigern darüber Gedanken gemacht hätten:
So my colleague tried a new approach, which I think was to say: we have a few percent of the human genome sequences (albeit mostly around genes of interest and not randomly sampled). How many genes have been found? And what would that extrapolate out to for the whole genome.
His conclusion was so shocking I admit I refused to believe it at first, and never quite bought into it. I think it was about 25-30K. How could the textbooks be off by 2X-3X? I could believe the other genomics companies might be optimistic in interpreting their data, but could they really be deluding themselves that much??
But, the logic was hard to assault. In order for his estimate to be low by a lot, you would have to posit that the genomic regions sequenced to date were unusually gene poor -- and that the rest of the genome was packed.
Beide Artikel sind sehr lesenswert, und schon allein deshalb interessant, weil man über die jungen Jahre der Genomik meistens nur von der Seite der akademischen Forschung hört.
Dienstag, Februar 03, 2009
(leider keine) JoVE Videos
Seit ich das letzte Mal ein Video aus dem Journal of Visualized Experiments (JoVE) vorgestellt habe, ist schon ein wenig Zeit vergangen. Ich habe natürlich immer mal wieder ein Auge reingeworfen, aber die Art der eingestellten Videos hat sich leider geändert. Während es zunächst noch Videos von kurzen Experimenten waren, die Arbeitsgruppen über ihre Ergebnisse drehten, werden nun in den Videos überwiegend die Methoden der Arbeitsgruppen vorgestellt.
Solche Videos sind aber leider höchstens für Leute interessant, die auf einem ähnlichen Gebiet arbeiten.
So habe ich mir etwa angesehen, wie man Antikörperfärbungen an Hühnerembryonen macht, mit welchem Versuchsaufbau man die Rolle von Geruchssignalen auf den Flug von Drosophilas untersuchen kann, oder auch wie man an methylierte DNA kommt.
Hört sich alles sehr spannend an, ist dann aber nach der kurzen Einleitung schnell recht langweilig. Ich bleibe aufmerksam, glaube aber leider nicht, dass ich so bald wieder über ein spannendes Video berichten kann.
Freitag, Januar 30, 2009
Spielwiese Bioinformatik
Mit all den vielen nützlichen Werkzeugen, die die Bioinformatiker produzieren, um uns Biologen die Arbeit zu erleichtern, haben wir mittlerweile einen Punkt erreicht, der auch interessierten Laien einen spielerischen Einstieg in die Berge von Daten ermöglicht.
Ein sehr gutes Beispiel dafür ist der Genome Projector, der Genomdaten von vielen (bisher nur) Bakterienarten mithilfe dem bekannten Google Maps-Interface darstellt.
Das Referenzgenom des Laborstammes K12 von Escherichia coli (leicht in der Liste zu finden, es ist bereits mit einem Balken markiert) ist ein guter Startpunkt für jeden, der mal einen Blick reinwerfen möchte. Wer kann in der Pathway Map den Citratzyklus finden?
Montag, Januar 26, 2009
Projekt Paperübersicht #2: Der RTR-Komplex in Pflanzen?
Und weiter gehts mit der Besprechung unseres aktuellen Papers! Während es in Teil 1 noch um ein wenig Hintergrund für die beteiligten Gene/Proteine ging, gehts heute ins Pflanzengenom und die Frage, ob es diesen RTR-Komplex auch in der Modellpflanze Arabidopsis thaliana gibt.
Den Großteil unserer Arbeit machen wir mit Insertionsmutanten. Das sind Pflanzen, bei denen mit Hilfe des Bodenbakteriums Agrobacterium tumefaciens relativ große DNA-Fragmente in die Sequenz eines Gens eingeführt wurden. Dies führt im Endeffekt dazu, dass das Proteinprodukt dieses Gens nicht mehr hergestellt werden kann, die Pflanzenlinie unterscheidet sich also von Wildtyppflanzen nur darin, dass ein bestimmtes Gen ausgeschaltet wurde. Der Sinn hinter der Untersuchung von diesen Knockouts ist schnell einleuchtend: Vergleicht man Wildtyp und Knockoutlinie, dann ist sehr wahrscheinlich, dass jeder zusätzliche Defekt in der Knockoutlinie auf dem Ausfall des Gens beruht. Jetzt muss man nur noch umdenken - der Ausfall eines Gens führt zu bestimmtem Defekt, dann erfüllt dieses Gen normalerweise diese bestimmte Funktion, die ein Entstehen des Defekts verhindert.
Zunächst muss man sich natürlich fragen: Gibt es die Gene des RTR-Komplexes überhaupt in Arabidopsis? Hier kann man sich heutzutage sehr viel Arbeit sparen, dank sehr guter Bioinformatik und den frei zugänglichen Genomdatenbanken vieler Organismen. Was wir fanden, passt sehr gut den bereits beschriebenen Genen, vor allem aus der Bäckerhefe Saccharomyces cerevisiae und dem Menschen.
Für das Gen RMI1 (bzw. BLAP75) gibt es im Arabidopsisgenom zwei mögliche Kandidaten. Einer davon (das Gen At5g19950) scheint nicht exprimiert zu werden, und auch von uns untersuchte Insertionsmutanten waren völlig unauffällig. Hierbei könnte es sich also um ein Pseudogen handeln. Der zweite Kandidat (At5g63540) war dafür umso interessanter, wie ich heute und in den folgenden Posts zu unserem Paper zeigen will. Dieses Gen wurde von uns darum AtRMI1 getauft [1].
Auf zum T aus RTR - der Topoisomerase. Hier war es leichter, weil als Homolog zu TOP3 bzw. TOPO3α nur ein mögliches Gen in Frage kam, At5g63920 oder AtTOP3α.
Ein wenig komplizierter wird es bei der RecQ Helikase. Bei dieser Familie wissen wir schon länger, dass es in Arabidopsis sieben Mitglieder gibt. Welche von diesen sieben ist nun aber das funktionelle Homolog zu der einzigen RecQ Helikase in Hefe, SGS1? Im Menschen ist dies unter fünf Familienmitgliedern das Gen BLM, und mit dem Aufbau dieser beiden Gene bewaffnet fallen schon ein paar der Arabdopsis RecQ Helikasen raus. Von den restlichen bleibt dann nur noch RECQ4A (At1g10930) übrig, wenn man bereits bekannte Eigenschaften der Mitglieder der RecQ Familie in Arabidopsis mit einbezieht (Hartung et al., 2007).
Glücklicherweise waren für diese Gene dann auch Insertionsmutanten verfügbar, mit denen wir arbeiten konnten.
Zum Abschluss jetzt noch ein paar "richtige" Daten. Die Beschreibung, wie und warum man bestimmte Gene überhaupt gefunden und benutzt hat, und wie die Mutanten aufgebaut sind, ist zwar ein wichtiger Teil eines Papers - es ist aber eher langweilig.
Es gibt eine relativ einfache Methode, die Beteiligung eines Gens bzw. dessen Proteinprodukts an der DNA Reparatur zu untersuchen: Schädigt man die DNA absichtlich, dann müssen diese Schäden repariert werden. Ist nun aber ein Gen ausgeschaltet, das in die Reparatur der DNA involviert ist, dann funktioniert die Reparatur logischerweise nicht mehr so gut. Das kann man auf verschiedene Weisen messen, wir bestimmen das relative Frischgewicht von behandelten Keimlingen verglichen mit gleich alten unbehandelten Keimlingen. Denn Probleme bei der DNA-Reparatur resultieren beispielsweise im Absterben der betroffenen Zellen, die sich dann auch nicht mehr Teilen oder Wachsen können. Die Folge: Kleinere, leichtere Keimlinge.
Die Bandbreite an möglichen Schäden an der DNA ist unheimlich groß, entsprechend gibt es auch jede Menge von Reparaturwegen. Indem man die Organismen verschiedenen Stoffen mit bekannten Schadeffekten an der DNA aussetzt, kann man mit diesem Versuch auch eine erste Einordnung der untersuchten Gene in diese Reparaturwege vornehmen. Eine Knockoutmutante wird nämlich nur dann sensitiver als der Wildtyp auf einen Stoff reagieren, wenn es in dem betroffenen Reparaturweg aktiv ist.
In dieser Abbildung sind Sensitivitäten von Knockoutmutanten der Gene RECQ4A, TOP3α und RMI1 gegenüber verschiedenen Mutagenen gezeigt. Gegen Methylmethansulfonat (MMS, A in der Abbildung) sind viele Gene der homologen Rekombination sensitiv, so auch unsere drei Gene. MMS erzeugt Addukte an der DNA, indem es eine Methylgruppe an Stickstoffatome in den Basen der DNA hängt. Dies hat zu Folge, dass die normale Doppelhelix verzerrt wird, und elementare Vorgänge wie die Transkription und Replikation nicht mehr stattfinden können. Dies ist wahrscheinlich auch die Verbindung mit der homologen Rekombination, da sie mithilft Probleme direkt an der Replikationsgabel zu beheben. Davon abgesehen können Schäden durch eine Alkylierung aber auch durch die Reparaturwege der Basenexzisionsreparatur und der Nukleotidexzisionsreparatur behoben werden [2]. Die Ungenauigkeit dieser beiden Wege führt übrigens über den Umweg von Mutationen zu einer krebsfördernden Wirkung von MMS.
Cisplatin (genauer cis-Diamindichlorplatin, B in der Abbildung) ist ein interessanter Stoff. Über die eher zufällige Entdeckung dieses kleinen Moleküls habe ich schon mal geschrieben. Heute ist es einerseits eines der am häufigsten eingesetzten Chemotherapeutika, andererseits aber auch eines der bestuntersuchten Stoffe, was die Mechanismen der DNA-Schädigung angeht. Was passiert, wenn Cisplatin in die Zelle kommt? Das zentrale Platinatom reagiert freudig mit so ziemlich jedem Molekül, das es in die Finger kriegt. Deshalb findet man dann Platinaddukte an Zuckern, Fetten, Proteinen, aber eben auch der DNA. Blöd an der Sache ist aber, dass Cisplatin über seine beiden Chloridgruppen auch zweimal reagieren kann, und damit zwei vorher unverbundene Moleküle kovalent verknüpft. So werden dann schon mal Proteine an die DNA gebunden, oder noch schlimmer, zwei Basen der DNA kovalent verbunden. Dies nennt man Crosslinking, und davon gibt es zwei Möglichkeiten: entweder werden zwei Basen aus unterschiedlichen DNA-Strängen verknüpft (=Interstrang-Crosslink), oder es werden zwei Basen innerhalb eines Stranges verknüpft (=Intrastrang-Crosslink). Letzteres ist bei Cisplatin das häufigere Produkt, und auch hier liegen die Reparaturaufgaben bei der Nukleotidexzisionsreparatur und der homologen Rekombination (die besonders während der Replikation).
Zuletzt noch Camptothecin (CPT, C in der Abbildung). Das ist ein Alkaloid, das beispielsweise von der Pflanze Camptotheca acuminata zur Schädlingsabwehr gebildet wird. Und die Schädlinge, die an der Pflanze knabbern tun mir wirklich leid: Im vorigen Teil habe ich knapp beschrieben, was eine Topoisomerase mit der DNA macht. Camptothecin behindert diesen Vorgang der Topoisomerase 1. Genau in dem Zustand, wenn TOP1 kovalent mit der DNA verbunden ist und ein Einzelstrangbruch in der DNA vorliegt, bindet CPT daran und verhindert, dass die Topoisomerase die Lücke schließt und sich von der DNA löst. Dies hat zur Folge, dass bei der Replikation einerseits ein Protein kovalent verbunden auf der DNA sitzt und die Replikationsproteine behindert, und dass außerdem durch das Entwinden des Doppelstrangs aus dieser Lücke in der DNA plötzlich ein Doppelstrangbruch wird. Großes Problem, und sehr wahrscheinlich der Tod des hungrigen Schädlings [3].
Wie man sehen kann, sind alle Mutanten sensitiver als der Wildtyp (Col-0 in der Abbildung) gegenüber MMS und Cisplatin. Gegen CPT ist dagegen nur die Knockoutmutante von TOP3α sensitiv, die beiden anderen nicht. top3A-2 reagiert genau genommen auch auf MMS und Cisplatin sensitiver als recq4A-4 und rmi1-2. Während nun diese gemeinsamen Sensitivitäten eines der Indizien sind, dass die drei Proteine ihre Aufgaben gemeinsam erfüllen (also möglicherweise in einem RTR-Komplex), deuten die Resultate auch auf eine Sonderrolle für TOP3α hin. Auf die will ich aber erst im nächsten oder übernächsten Post eingehen - mit nem Cliffhanger müsst ihr einfach wiederkommen, oder?
[1] So wirklich neue und kreative Namen gibts bei Genen eher selten, aber es kommt vor. Siehe etwa das Gen SUPERMAN und sein Antagonist KRYPTONITE...
[2] Wenn ich jetzt noch anfange, jeden Reparaturweg ausführlich zu beschreiben werde ich gar nicht mehr fertig mit dem Post. Ich hab da aber eine nette Idee: Ich könnte den Mutagenen eigene Posts widmen, und dabei dann auch auf die relevanten Reparaturwege eingehen.
[3] Die Camptothecin-produzierenden Pflanzen besitzen übrigens TOP1-Gene mit leicht veränderten Sequenzen, so dass sie selbst nicht anfällig gegenüber CPT sind (Sirikantaramas et al, 2008).
Den Großteil unserer Arbeit machen wir mit Insertionsmutanten. Das sind Pflanzen, bei denen mit Hilfe des Bodenbakteriums Agrobacterium tumefaciens relativ große DNA-Fragmente in die Sequenz eines Gens eingeführt wurden. Dies führt im Endeffekt dazu, dass das Proteinprodukt dieses Gens nicht mehr hergestellt werden kann, die Pflanzenlinie unterscheidet sich also von Wildtyppflanzen nur darin, dass ein bestimmtes Gen ausgeschaltet wurde. Der Sinn hinter der Untersuchung von diesen Knockouts ist schnell einleuchtend: Vergleicht man Wildtyp und Knockoutlinie, dann ist sehr wahrscheinlich, dass jeder zusätzliche Defekt in der Knockoutlinie auf dem Ausfall des Gens beruht. Jetzt muss man nur noch umdenken - der Ausfall eines Gens führt zu bestimmtem Defekt, dann erfüllt dieses Gen normalerweise diese bestimmte Funktion, die ein Entstehen des Defekts verhindert.
Zunächst muss man sich natürlich fragen: Gibt es die Gene des RTR-Komplexes überhaupt in Arabidopsis? Hier kann man sich heutzutage sehr viel Arbeit sparen, dank sehr guter Bioinformatik und den frei zugänglichen Genomdatenbanken vieler Organismen. Was wir fanden, passt sehr gut den bereits beschriebenen Genen, vor allem aus der Bäckerhefe Saccharomyces cerevisiae und dem Menschen.
Für das Gen RMI1 (bzw. BLAP75) gibt es im Arabidopsisgenom zwei mögliche Kandidaten. Einer davon (das Gen At5g19950) scheint nicht exprimiert zu werden, und auch von uns untersuchte Insertionsmutanten waren völlig unauffällig. Hierbei könnte es sich also um ein Pseudogen handeln. Der zweite Kandidat (At5g63540) war dafür umso interessanter, wie ich heute und in den folgenden Posts zu unserem Paper zeigen will. Dieses Gen wurde von uns darum AtRMI1 getauft [1].
Auf zum T aus RTR - der Topoisomerase. Hier war es leichter, weil als Homolog zu TOP3 bzw. TOPO3α nur ein mögliches Gen in Frage kam, At5g63920 oder AtTOP3α.
Ein wenig komplizierter wird es bei der RecQ Helikase. Bei dieser Familie wissen wir schon länger, dass es in Arabidopsis sieben Mitglieder gibt. Welche von diesen sieben ist nun aber das funktionelle Homolog zu der einzigen RecQ Helikase in Hefe, SGS1? Im Menschen ist dies unter fünf Familienmitgliedern das Gen BLM, und mit dem Aufbau dieser beiden Gene bewaffnet fallen schon ein paar der Arabdopsis RecQ Helikasen raus. Von den restlichen bleibt dann nur noch RECQ4A (At1g10930) übrig, wenn man bereits bekannte Eigenschaften der Mitglieder der RecQ Familie in Arabidopsis mit einbezieht (Hartung et al., 2007).
Glücklicherweise waren für diese Gene dann auch Insertionsmutanten verfügbar, mit denen wir arbeiten konnten.
Zum Abschluss jetzt noch ein paar "richtige" Daten. Die Beschreibung, wie und warum man bestimmte Gene überhaupt gefunden und benutzt hat, und wie die Mutanten aufgebaut sind, ist zwar ein wichtiger Teil eines Papers - es ist aber eher langweilig.
Es gibt eine relativ einfache Methode, die Beteiligung eines Gens bzw. dessen Proteinprodukts an der DNA Reparatur zu untersuchen: Schädigt man die DNA absichtlich, dann müssen diese Schäden repariert werden. Ist nun aber ein Gen ausgeschaltet, das in die Reparatur der DNA involviert ist, dann funktioniert die Reparatur logischerweise nicht mehr so gut. Das kann man auf verschiedene Weisen messen, wir bestimmen das relative Frischgewicht von behandelten Keimlingen verglichen mit gleich alten unbehandelten Keimlingen. Denn Probleme bei der DNA-Reparatur resultieren beispielsweise im Absterben der betroffenen Zellen, die sich dann auch nicht mehr Teilen oder Wachsen können. Die Folge: Kleinere, leichtere Keimlinge.
Die Bandbreite an möglichen Schäden an der DNA ist unheimlich groß, entsprechend gibt es auch jede Menge von Reparaturwegen. Indem man die Organismen verschiedenen Stoffen mit bekannten Schadeffekten an der DNA aussetzt, kann man mit diesem Versuch auch eine erste Einordnung der untersuchten Gene in diese Reparaturwege vornehmen. Eine Knockoutmutante wird nämlich nur dann sensitiver als der Wildtyp auf einen Stoff reagieren, wenn es in dem betroffenen Reparaturweg aktiv ist.

In dieser Abbildung sind Sensitivitäten von Knockoutmutanten der Gene RECQ4A, TOP3α und RMI1 gegenüber verschiedenen Mutagenen gezeigt. Gegen Methylmethansulfonat (MMS, A in der Abbildung) sind viele Gene der homologen Rekombination sensitiv, so auch unsere drei Gene. MMS erzeugt Addukte an der DNA, indem es eine Methylgruppe an Stickstoffatome in den Basen der DNA hängt. Dies hat zu Folge, dass die normale Doppelhelix verzerrt wird, und elementare Vorgänge wie die Transkription und Replikation nicht mehr stattfinden können. Dies ist wahrscheinlich auch die Verbindung mit der homologen Rekombination, da sie mithilft Probleme direkt an der Replikationsgabel zu beheben. Davon abgesehen können Schäden durch eine Alkylierung aber auch durch die Reparaturwege der Basenexzisionsreparatur und der Nukleotidexzisionsreparatur behoben werden [2]. Die Ungenauigkeit dieser beiden Wege führt übrigens über den Umweg von Mutationen zu einer krebsfördernden Wirkung von MMS.
Cisplatin (genauer cis-Diamindichlorplatin, B in der Abbildung) ist ein interessanter Stoff. Über die eher zufällige Entdeckung dieses kleinen Moleküls habe ich schon mal geschrieben. Heute ist es einerseits eines der am häufigsten eingesetzten Chemotherapeutika, andererseits aber auch eines der bestuntersuchten Stoffe, was die Mechanismen der DNA-Schädigung angeht. Was passiert, wenn Cisplatin in die Zelle kommt? Das zentrale Platinatom reagiert freudig mit so ziemlich jedem Molekül, das es in die Finger kriegt. Deshalb findet man dann Platinaddukte an Zuckern, Fetten, Proteinen, aber eben auch der DNA. Blöd an der Sache ist aber, dass Cisplatin über seine beiden Chloridgruppen auch zweimal reagieren kann, und damit zwei vorher unverbundene Moleküle kovalent verknüpft. So werden dann schon mal Proteine an die DNA gebunden, oder noch schlimmer, zwei Basen der DNA kovalent verbunden. Dies nennt man Crosslinking, und davon gibt es zwei Möglichkeiten: entweder werden zwei Basen aus unterschiedlichen DNA-Strängen verknüpft (=Interstrang-Crosslink), oder es werden zwei Basen innerhalb eines Stranges verknüpft (=Intrastrang-Crosslink). Letzteres ist bei Cisplatin das häufigere Produkt, und auch hier liegen die Reparaturaufgaben bei der Nukleotidexzisionsreparatur und der homologen Rekombination (die besonders während der Replikation).
Zuletzt noch Camptothecin (CPT, C in der Abbildung). Das ist ein Alkaloid, das beispielsweise von der Pflanze Camptotheca acuminata zur Schädlingsabwehr gebildet wird. Und die Schädlinge, die an der Pflanze knabbern tun mir wirklich leid: Im vorigen Teil habe ich knapp beschrieben, was eine Topoisomerase mit der DNA macht. Camptothecin behindert diesen Vorgang der Topoisomerase 1. Genau in dem Zustand, wenn TOP1 kovalent mit der DNA verbunden ist und ein Einzelstrangbruch in der DNA vorliegt, bindet CPT daran und verhindert, dass die Topoisomerase die Lücke schließt und sich von der DNA löst. Dies hat zur Folge, dass bei der Replikation einerseits ein Protein kovalent verbunden auf der DNA sitzt und die Replikationsproteine behindert, und dass außerdem durch das Entwinden des Doppelstrangs aus dieser Lücke in der DNA plötzlich ein Doppelstrangbruch wird. Großes Problem, und sehr wahrscheinlich der Tod des hungrigen Schädlings [3].
Wie man sehen kann, sind alle Mutanten sensitiver als der Wildtyp (Col-0 in der Abbildung) gegenüber MMS und Cisplatin. Gegen CPT ist dagegen nur die Knockoutmutante von TOP3α sensitiv, die beiden anderen nicht. top3A-2 reagiert genau genommen auch auf MMS und Cisplatin sensitiver als recq4A-4 und rmi1-2. Während nun diese gemeinsamen Sensitivitäten eines der Indizien sind, dass die drei Proteine ihre Aufgaben gemeinsam erfüllen (also möglicherweise in einem RTR-Komplex), deuten die Resultate auch auf eine Sonderrolle für TOP3α hin. Auf die will ich aber erst im nächsten oder übernächsten Post eingehen - mit nem Cliffhanger müsst ihr einfach wiederkommen, oder?
[1] So wirklich neue und kreative Namen gibts bei Genen eher selten, aber es kommt vor. Siehe etwa das Gen SUPERMAN und sein Antagonist KRYPTONITE...
[2] Wenn ich jetzt noch anfange, jeden Reparaturweg ausführlich zu beschreiben werde ich gar nicht mehr fertig mit dem Post. Ich hab da aber eine nette Idee: Ich könnte den Mutagenen eigene Posts widmen, und dabei dann auch auf die relevanten Reparaturwege eingehen.
[3] Die Camptothecin-produzierenden Pflanzen besitzen übrigens TOP1-Gene mit leicht veränderten Sequenzen, so dass sie selbst nicht anfällig gegenüber CPT sind (Sirikantaramas et al, 2008).
Donnerstag, Januar 15, 2009
Wieso man zumindest naturwissenschaftliche Kenntnisse der Mittelstufe haben sollte, wenn man medizinische Pressemitteilungen herausgibt...
...oder: Gene, Gene, Gene und die böse junk DNA!

Dies ist mal wieder ein gutes Beispiel dafür, warum ich normalerweise verzichte, Pressemeldungen zu lesen. Eine Forschergruppe hat in einem aktuellen Paper in Nature gezeigt, dass eine microRNA (miR-21) zur Erkrankung der Herzmuskelschwäche beitragen kann. Das interessante daran ist, dass sie eine Verbindung zwischen einem der vielen Gene Silencing-Mechanismen und einer menschlichen Erkrankung zeigen konnten. Wohlgemerkt, diese Verbindung ist schon länger bekannt, wie die Autoren selbst schon im Abstract des Artikels schreiben. Soweit ist alles noch in Ordnung.
Aber was macht die Pressestelle des an der Arbeit beteiligten Rudolf-Virchow-Zentrum daraus?
Gehen wir das Ganze doch von vorne nach hinten durch. Der Titel ist schon super, "Genetischer Müll" gleich in scare quotes, und irgendwie klingt es so, als ob endlich der ultimative Grund der Herzmuskelschwäche gefunden wäre. Auf den genetischen Müll, also die junk DNA, möchte ich gleich ausführlicher eingehen, jetzt wird erst mal diese Meldung zerpflückt.
Erster Satz - microRNAs (schon wieder scare quotes) sind keineswegs "Bruchstücke des Erbguts", und sie galten auch nicht bis vor kurzem als unwichtig. Vielmehr werden microRNAs genauso wie alle anderen Gene (also auch die, die für Proteine kodieren) zunächst mal transkribiert, d.h. es wird eine Abschrift des Gens in Form einer RNA hergestellt. Bei proteinogenen Genen nennt man diese RNA dann mRNA (messenger RNA). Bei Genen für microRNAs, nunja, microRNA halt. Wären es wirklich Bruchstücke der DNA wäre es einerseits microDNA, und andererseits wäre die Zelle tot (Chromosomen zerbrochen und so). Eine schnelle Suche bei Pubmed ergibt außerdem, dass mindestens seit 2001 über microRNAs geschrieben wird - keineswegs "vor kurzem" also. Nehmen wir nicht nur diese Subfamilie der regulatorischen RNAs, sondern den gesamten Prozess des gene silencing, dann wird die Aussage noch lächerlicher. Über post-transcriptional gene-silencing wird dann auch schon seit 1955 geschrieben (mit bisher fast 19000 veröffentlichten Artikeln), und auf der Informationsseite für den (im Pressetext ja ausdrücklich erwähnten) Nobelpreis (Fire und Mello, 2006) wird direkt Bezug genommen auf Arbeiten in Pflanzen und Pilzen von 1990.
Im zweiten Absatz geht es dann munter so weiter. Da widerspricht sich der Text erstmal heftig. Einerseits sollen nur 1,5% des Genoms Gene sein ("für die Herstellung unserer Proteine benötigt"), andererseits ist das restliche Genom aber wohl voll von Genen ("Der Rest der Gene")!
Dieser Satz ist sowieso voll von Fehlern:
Jetzt aber zur junk DNA. Wann immer in den letzten Jahren jemand einen Effekt gefunden hat, der nicht dem Schema Gen - mRNA - Protein folgt, hat er gleich die böse junk DNA ausgepackt. Demnach sind ja alle anderen Molekularbiologen so beschränkt, dass die alles im Genom, was nicht diesem einfachen Schema entspricht, als genetischen Müll abtun, der völlig unnötig rumliegt und die Suche nach Genen erschwert. Jetzt kommt aber der Underdog, der mit seiner tollen neuen Entdeckung dem engstirnigen wissenschaftlichen Establishment entgegentritt. Klar, dass so eine Darstellung von den Medien gerne aufgegriffen wird.
Mit dieser Sichtweise gibt es nur ein Problem: Sie ist falsch, und das schon fast so lange, wie wir überhaupt wissen dass es Gene gibt und dass die DNA das Erbmaterial in der Zelle ist. Nur wenige Jahre nach der Beschreibung der DNA-Struktur durch Watson und Crick 1953 wurde die Translation in ihren Grundzügen aufgeklärt, also das Herstellen von Proteinen aus der Information der mRNA. Hier war aber schon klar, dass für diesen Prozess RNAs benötigt werden, von denen keine Proteine produziert werden: die tRNAs und die rRNAs. Auch das lernt eigentlich jeder in der Schule. Die Grundannahme, nicht-kodierende RNAs mit einer Funktion in der Zelle wären erst seit ein paar Jahren bekannt, ist also nicht nur falsch - diese RNAs gehören zum Establishment!
Das ist der eine Aspekt. Die andere Seite hat mit der Definition des Begriffs junk DNA zu tun. Zunächst mal ist nicht alles "Müll", von dem wir die Funktion nicht kennen. Mit junk DNA werden Elemente im Genom bezeichnet, die nachweislich keine Funktion haben! Der Nobelpreisträger Sydney Brenner gibt in diesem Video auf iBioSeminars (ab ca. 11:20) ein sehr gutes Beispiel. Die Alu Sequenz mit einer Länge von etwa 300 Basenpaaren kommt im menschlichen Genom in mehreren Millionen Kopien vor; sie macht damit je nach Schätzung zwischen 10 und 30% des gesamten menschlichen Genoms aus! Funktion? Fehlanzeige! Letzten Endes sind Alu-Elemente Parasiten von genetischen Parasiten.
Sogenannte Transposons sind genetische Elemente, die bestimmte Sequenzen an ihren Enden tragen und dazwischen Gene kodieren, deren Proteinprodukte diese Endsequenzen erkennen und dort Schnitte in die DNA setzen. Ein Transposon kann so per cut and paste von einer Stelle im Genom an eine andere wandern. Einen Nutzen für das Wirtsgenom hat das erstmal keinen, Transposons nutzen es nur als Transportvehikel. Alu-Elemente und andere, ähnliche Sequenzen gehen dabei noch einen Schritt weiter: Um selbst Gene zu tragen sind sie zu klein. An ihren Ende besitzen sie aber auch die Sequenzen, die von den Transposonproteinen erkannt werden. Alu-Elemente sind also ehemalige Transposons, die sich den Aufwand mit den Genen gespart haben und ihre noch funktionsfähigen Transposonkollegen ausnutzen. Wiederum aber kein direkter Nutzen für die Wirtszelle.
Larry Moran hat in den letzten Monaten verschiedenste Elemente im menschlichen Genom aufgelistet, die gesichert keine Funktion besitzen, also unter junk DNA fallen. Die Alu Elemente sind auch dabei (zu finden unter SINEs). Insgesamt ist er jetzt schon, ohne alle Arten von funktionslosen Elementen im Genom genannt zu haben, bei über 50% des Umfangs des Genoms - und das ist eine sehr zurückhaltende Schätzung!
In dem oben genannten Video weist Sydney Brenner auch auf ein weit verbreitetes Missverständnis hin, was den Begriff junk DNA angeht. Mit junk wird nämlich im Englischen keineswegs der Müll gemeint, den man wegwirft. Eine bessere Übersetzung wäre wohl das Wort Gerümpel; laut Brenner Dinge, die man gerade nicht brauchen kann, die man deshalb auf dem Dachboden lagert.
Dieses Verständnis von junk DNA löst dann auch eine häufig gegen sie gerichtete Kritik in Wohlgefallen auf: Nur weil aktuell kein Nutzen für diese Elemente vorhanden ist, heißt das noch lange nicht, dass diese Sequenzen nicht irgendwann mal benutzt werden können!
[1] von der aktuellen Diskussion über stochastische Transkription und dem Nutzen der so hergestellten RNA mal abgesehen.
Aber was macht die Pressestelle des an der Arbeit beteiligten Rudolf-Virchow-Zentrum daraus?
"Genetischer Müll" löst Herzmuskelschwäche ausDie Pressemeldung geht noch weiter, befasst sich mit diesem doch scheinbar so hochinteressanten Thema aber nicht mehr. Vielleicht, weil in der Pressestelle nichts tiefschürfenderes als dieses oberflächliche Blabla bekannt war?Würzburg, 30.11.2008. Winzige Bruchstücke des Erbguts - so genannte "micro-RNAs", die bis vor kurzem als unwichtig galten, könnten jetzt die Prävention, Diagnose und Therapie der Herzmuskelschwäche revolutionieren. Würzburger Forscher fanden eine solche erstmals im Herzen, blockierten sie und konnten damit nicht nur gefährdete Mäuse vor dem Ausbruch der Erkrankung schützen, sondern auch an Herzmuskelschwäche erkrankte Mäuse heilen. Die Ergebnisse beschreiben die Wissenschaftler der Universität Würzburg in dem renommierten Wissenschaftsmagazin Nature.Die Entschlüsselung des menschlichen Genoms brachte eine überraschende Nachricht mit sich: Nur ungefähr 1,5 Prozent der gesamten genetischen Information wird für die Herstellung unserer Proteine benötigt, wobei die Gene über eine Art Kopie, die Boten-RNA, in Proteine umgeschrieben werden. Der Rest der Gene galt lange als bedeutungsloser "genetischer Müll", weil deren RNA ohne nennenswerte Funktion sei. 2006 wurde jedoch für die Entdeckung, dass RNAs, aus denen keine Proteine entstehen, auch wichtige Aufgaben im Körper besitzen den Medizin-Nobelpreis verliehen [sic]. Diese RNA-Stücke regulieren die Bildung der Proteine über Bindung an die Boten-RNA direkt. Geht hier etwas schief, produziert der Körper also beispielsweise zu viel oder zu wenig Proteine, gerät die Körperzelle aus dem Gleichgewicht - Krankheiten entstehen.
Gehen wir das Ganze doch von vorne nach hinten durch. Der Titel ist schon super, "Genetischer Müll" gleich in scare quotes, und irgendwie klingt es so, als ob endlich der ultimative Grund der Herzmuskelschwäche gefunden wäre. Auf den genetischen Müll, also die junk DNA, möchte ich gleich ausführlicher eingehen, jetzt wird erst mal diese Meldung zerpflückt.
Erster Satz - microRNAs (schon wieder scare quotes) sind keineswegs "Bruchstücke des Erbguts", und sie galten auch nicht bis vor kurzem als unwichtig. Vielmehr werden microRNAs genauso wie alle anderen Gene (also auch die, die für Proteine kodieren) zunächst mal transkribiert, d.h. es wird eine Abschrift des Gens in Form einer RNA hergestellt. Bei proteinogenen Genen nennt man diese RNA dann mRNA (messenger RNA). Bei Genen für microRNAs, nunja, microRNA halt. Wären es wirklich Bruchstücke der DNA wäre es einerseits microDNA, und andererseits wäre die Zelle tot (Chromosomen zerbrochen und so). Eine schnelle Suche bei Pubmed ergibt außerdem, dass mindestens seit 2001 über microRNAs geschrieben wird - keineswegs "vor kurzem" also. Nehmen wir nicht nur diese Subfamilie der regulatorischen RNAs, sondern den gesamten Prozess des gene silencing, dann wird die Aussage noch lächerlicher. Über post-transcriptional gene-silencing wird dann auch schon seit 1955 geschrieben (mit bisher fast 19000 veröffentlichten Artikeln), und auf der Informationsseite für den (im Pressetext ja ausdrücklich erwähnten) Nobelpreis (Fire und Mello, 2006) wird direkt Bezug genommen auf Arbeiten in Pflanzen und Pilzen von 1990.
Im zweiten Absatz geht es dann munter so weiter. Da widerspricht sich der Text erstmal heftig. Einerseits sollen nur 1,5% des Genoms Gene sein ("für die Herstellung unserer Proteine benötigt"), andererseits ist das restliche Genom aber wohl voll von Genen ("Der Rest der Gene")!
Dieser Satz ist sowieso voll von Fehlern:
Der Rest der Gene galt lange als bedeutungsloser "genetischer Müll", weil deren RNA ohne nennenswerte Funktion sei.Also, keine Definition was ein Gen ist. Eigentlich sogar das Eingeständnis, seit der 7. Klasse nicht mehr im Bio-Unterricht aufgepasst zu haben. Wörtlich genommen geht der Verfasser wohl davon aus, dass diese 98,5% des Genoms (weil sie ja angeblich Gene sind), auch in RNA umgeschrieben werden. Dies passiert zum allergrößten Teil aber nicht - das Genom ist transkriptionell überwiegend tot. Noch wichtiger, bisher hat noch niemand behauptet, dass eine einmal hergestellte RNA keine Funktion habe [1].
Jetzt aber zur junk DNA. Wann immer in den letzten Jahren jemand einen Effekt gefunden hat, der nicht dem Schema Gen - mRNA - Protein folgt, hat er gleich die böse junk DNA ausgepackt. Demnach sind ja alle anderen Molekularbiologen so beschränkt, dass die alles im Genom, was nicht diesem einfachen Schema entspricht, als genetischen Müll abtun, der völlig unnötig rumliegt und die Suche nach Genen erschwert. Jetzt kommt aber der Underdog, der mit seiner tollen neuen Entdeckung dem engstirnigen wissenschaftlichen Establishment entgegentritt. Klar, dass so eine Darstellung von den Medien gerne aufgegriffen wird.
Mit dieser Sichtweise gibt es nur ein Problem: Sie ist falsch, und das schon fast so lange, wie wir überhaupt wissen dass es Gene gibt und dass die DNA das Erbmaterial in der Zelle ist. Nur wenige Jahre nach der Beschreibung der DNA-Struktur durch Watson und Crick 1953 wurde die Translation in ihren Grundzügen aufgeklärt, also das Herstellen von Proteinen aus der Information der mRNA. Hier war aber schon klar, dass für diesen Prozess RNAs benötigt werden, von denen keine Proteine produziert werden: die tRNAs und die rRNAs. Auch das lernt eigentlich jeder in der Schule. Die Grundannahme, nicht-kodierende RNAs mit einer Funktion in der Zelle wären erst seit ein paar Jahren bekannt, ist also nicht nur falsch - diese RNAs gehören zum Establishment!
Das ist der eine Aspekt. Die andere Seite hat mit der Definition des Begriffs junk DNA zu tun. Zunächst mal ist nicht alles "Müll", von dem wir die Funktion nicht kennen. Mit junk DNA werden Elemente im Genom bezeichnet, die nachweislich keine Funktion haben! Der Nobelpreisträger Sydney Brenner gibt in diesem Video auf iBioSeminars (ab ca. 11:20) ein sehr gutes Beispiel. Die Alu Sequenz mit einer Länge von etwa 300 Basenpaaren kommt im menschlichen Genom in mehreren Millionen Kopien vor; sie macht damit je nach Schätzung zwischen 10 und 30% des gesamten menschlichen Genoms aus! Funktion? Fehlanzeige! Letzten Endes sind Alu-Elemente Parasiten von genetischen Parasiten.
Sogenannte Transposons sind genetische Elemente, die bestimmte Sequenzen an ihren Enden tragen und dazwischen Gene kodieren, deren Proteinprodukte diese Endsequenzen erkennen und dort Schnitte in die DNA setzen. Ein Transposon kann so per cut and paste von einer Stelle im Genom an eine andere wandern. Einen Nutzen für das Wirtsgenom hat das erstmal keinen, Transposons nutzen es nur als Transportvehikel. Alu-Elemente und andere, ähnliche Sequenzen gehen dabei noch einen Schritt weiter: Um selbst Gene zu tragen sind sie zu klein. An ihren Ende besitzen sie aber auch die Sequenzen, die von den Transposonproteinen erkannt werden. Alu-Elemente sind also ehemalige Transposons, die sich den Aufwand mit den Genen gespart haben und ihre noch funktionsfähigen Transposonkollegen ausnutzen. Wiederum aber kein direkter Nutzen für die Wirtszelle.
Larry Moran hat in den letzten Monaten verschiedenste Elemente im menschlichen Genom aufgelistet, die gesichert keine Funktion besitzen, also unter junk DNA fallen. Die Alu Elemente sind auch dabei (zu finden unter SINEs). Insgesamt ist er jetzt schon, ohne alle Arten von funktionslosen Elementen im Genom genannt zu haben, bei über 50% des Umfangs des Genoms - und das ist eine sehr zurückhaltende Schätzung!
In dem oben genannten Video weist Sydney Brenner auch auf ein weit verbreitetes Missverständnis hin, was den Begriff junk DNA angeht. Mit junk wird nämlich im Englischen keineswegs der Müll gemeint, den man wegwirft. Eine bessere Übersetzung wäre wohl das Wort Gerümpel; laut Brenner Dinge, die man gerade nicht brauchen kann, die man deshalb auf dem Dachboden lagert.
Most of the genome appears to be unneccesary; it is - if you like - call it rubbish. Now as you well know, there are two kinds of rubbish: The rubbish you keep, which we call junk, and the rubbish we throw away, which we call garbage.
Dieses Verständnis von junk DNA löst dann auch eine häufig gegen sie gerichtete Kritik in Wohlgefallen auf: Nur weil aktuell kein Nutzen für diese Elemente vorhanden ist, heißt das noch lange nicht, dass diese Sequenzen nicht irgendwann mal benutzt werden können!
[1] von der aktuellen Diskussion über stochastische Transkription und dem Nutzen der so hergestellten RNA mal abgesehen.
Montag, Januar 12, 2009
Projekt Paperübersicht #1: Der RTR-Komplex
Leider gab es nicht so viele Rückmeldungen auf meine Frage, ob ich über ein aktuelles Paper, bei dem ich Mitautor bin, hier berichten soll. Die Umfrage in der Sidebar wurde genau 1 Mal angeklickt. Da das Ergebnis nun aber bei 100% für das Erklären steht, werde ich das auch tun. Nur werde ich, wie caesar im Kommentarteil geschrieben hat, auf ein Einstellen bei researchblogging verzichten. Deren Richtlinien verbieten zwar nicht das Schreiben über eigene Paper, mir scheint das aber trotzdem nicht vertretbar zu sein.
Da in dem Paper mehrere Punkte zur Sprache kommen, die auch auf eigenen Beinen stehen können, werde ich die Besprechung des Papers aufteilen. So wird das nicht ein Megapost, und ich kann jeweils besser auf den Hintergrund eingehen.
Heute beginne ich damit, die für das Paper relevanten Gene und ihre Proteinprodukte kurz vorzustellen, dass jeder eine Vorstellung über ihre Funktion in der Zelle hat. Zentral steht hier ein Komplex aus drei Proteinen, die für sich alleine gänzlich unterschiedliche biochemische Eigenschaften haben.
Über die Familie der RecQ Helikasen habe ich bisher nur sehr wenig geschrieben, obwohl ich mich schon seit meiner Diplomarbeit mit ihnen beschäftige. Aus dem Biounterricht kennen manche vielleicht noch den Begriff der Helikase für ein Protein, das für das Kopieren der DNA (die Replikation) benötigt wird. Da in der DNA zwei Stränge aneinandergelagert sind, kann sie erst dann kopiert werden, wenn die Basenpaarungen aufgelöst wurden. Dies wird durch eine Gruppe von Proteinen namens Helikasen erreicht, die unter Energieverbrauch aus einem Doppelstrang zwei Einzelstränge machen. Danach kann dann das lustige DNA-Kopieren starten. Helikasen werden jedoch nicht nur während der Replikation gebraucht - die meisten Vorgänge an der DNA benötigen die Hilfe einer Helikase, warum es von denen im menschlichen Genom auch laut der Proteindatenbank UniProt über 150 gibt. Beschäftigt man sich ein wenig intensiver mit dem Metabolismus der DNA, dann läuft man fast zwangsläufig einer Familie von Helikasen (also eine Gruppe von Proteinen, deren Gene evolutionär verwandt sind und alle ein einziges Gen als gemeinsamen Vorfahren haben), den RecQ Helikasen. Das liegt daran, dass Vertreter dieser Familie verschiedenste Aufgaben im Erhalt der DNA, so wie wir sie kennen, besitzen: Sie sind aktiv in der Rekombination und der Reparatur von DNA, man findet sie an den Enden der Chromosomen, der Telomere, wo sie für den Erhalt dieser Strukturen beitragen und somit beispielsweise ein schnelles Altern unserer Zellen verhindern. Andere Familienmitglieder nehmen Funktionen im Gene Silencing wahr (das auch als RNAi bekannte Phänomen wurde 2006 mit dem Nobelpreis belohnt). Biochemisch erfüllen RecQ Helikasen diese Funktionen in der Regel, indem sie besondere DNA-Strukturen [1] erkennen, und sie unter Energieverbrauch wieder auflösen. Fallen diese Funktionen in tierischen Zellen aus, dann kann Krebs entstehen.
Die allermeisten einzelligen Lebewesen besitzen genau eine RecQ Helikase, die als Allroundtalent die meisten dieser Aufgaben erfüllt. Interessanter, aber auch komplizierter, wird es in vielzelligen Lebewesen, da diese mehrere Gene für RecQ Helikasen in ihren Genomen tragen, die die Aufgaben untereinander aufgeteilt haben. Menschen haben beispielsweise 5, Arabidopsis sogar 7 RecQ Gene. Ein recht gut untersuchtes Familienmitglied beim Menschen heißt BLM, weil es durch Mutation die verheerende Erbkrankheit Bloom Syndrom auslösen kann. Funktionell entspricht dies in Arabidopsis dem Gen RECQ4A. Beide unterdrücken die Rekombination und sind involviert in bestimmte Arten von DNA-Reparatur. Zumindest ein Teil dieser Aufgaben wird in dem RTR-Komplex wahrgenommen, um den es heute geht. Darum will ich es auch gut sein lassen für jetzt.
Das zweite Protein im Komplex ist eine Topoisomerase. Sie wird in der Bäckerhefe TOP3, in vielzelligen Eukaryoten TOPO3α genannt. Topoisomerasen lösen topologische Probleme der DNA - darum der Name. Ein einfaches Beispiel soll helfen zu verstehen, was damit gemeint sein soll: Stellt euch ein Gummiband vor; ein Ende macht ihr an einem Türgriff fest, das andere haltet ihr in der Hand. Nun verdrillt (überdreht) ihr das Gummiband. Wie lässt sich diese Überdrehung wieder auflösen, wenn die Enden fest verankert sind? Mit der DNA ist das etwas einfacher als mit einem Gummiband, aber genau das machen Topoisomerasen: Sie schneiden einen Strang durch, an dieser Position kann das Gummiband/die DNA nun frei drehen. Wenn die Überdrehung aufgelöst wurde (dies geschieht durch die in der Überdrehung gespeicherten Energie von selbst), schließt die Topoisomerase die Lücke wieder. Ein geschnittenes und geklebtes Gummiband würde man wohl nicht mehr benutzen, aber in der DNA bedeutet dies nur das Lösen und Verknüpfen einer Bindung im Molekül, das macht also keinen Unterschied [2].
Der dritte Komplexpartner heißt in der Bäckerhefe RMI1 und im Menschen BLAP75. Anders als die ersten beiden Proteine scheint es keine enzymatische Funktion zu besitzen. Trotzdem erfüllt der Komplex seine Aufgabe schlechter, wenn man dieses Protein daraus entfernt. Dies liegt wahrscheinlich daran, dass RMI1/BLAP75 einerseits die Erkennung von und Bindung an besondere DNA-Strukturen fördert, und andererseits Helikase und Topoisomerase im Komplex zusammenhält. Auf diese Weise können die beiden Proteine ihre Aufgaben kooperativ erfüllen.
Vor kurzem konnte gezeigt werden, dass der Komplex auch ein Protein namens RMI2/BLAP18 enthält. Dieses ist nahe verwandt mit RMI1, und beide ergänzen sich in ihrer Funktion. Außerdem ist schon bekannt, dass noch weitere, bisher unidentifizierte Proteine im Komplex enthalten sind.
Aufgrund der drei zentralen Proteine erhielt der Komplex jedoch seinen Namen - BTB für BLM, TOPO3α und BLAP75 im Menschen beziehungsweise RTR für RecQ Helikase, TOP3 und RMI1 in der Bäckerhefe. Was er genau mit der DNA anstellt, darauf will ich in einem gesonderten Post eingehen. Kurz erwähnen will ich nur noch, dass der RTR-Komplex vor kurzem die traurige Ehre zuteil wurde, von Kreationisten als "Argument" missbraucht zu werden.
[1] Wer sich schon gefragt hat, wo der nächste Post in der Serie DNA-Strukturen bleibt - schuldig im Sinne der Anklage. Es ist ja nicht so, dass mir da die Themen ausgingen. Es geht bald wieder weiter damit, versprochen!
[2] Es gibt noch eine zweite Form von Topoisomerasen. Die schneiden nicht einen, sondern beide Stränge der DNA durch. Das ist etwa dann nötig, wenn mehrere Chromosomen ineinander verknotet sind.
Freitag, Januar 09, 2009
Gehirn einschalten hilft, auch im Labor
Für viele Routinearbeiten im molekularbiologischen Labor gibt es heute von vielen Herstellern Kits. Du musst DNA isolieren? Kein Problem, mach die Schachtel auf, nimm ein paar kleine Plastikdinger, dann soviel Lösung X drauf, abzentrifugieren, Lösung Y drauf, fertig. Das hat gegenüber der alten Methode, alles selbst zu machen, natürlich Vorteile:
Die Ergebnisse sind in der Regel reproduzierbarer, man muss nicht mehr mit gefährlichen Chemikalien wie Chloroform oder Phenol hantieren, man ist auch schneller fertig.
Das Problem dabei: Gerade weil man nicht mehr selbst mit Chemikalien arbeitet, sondern nur noch fertige Lösungen mit nichtssagenden Namen benutzt, kennen viele Leute nicht die hinter dem Kit stehende Chemie. Es wird halt einfach nach Vorschrift vorgegangen. Ein zweiter Nebeneffekt der Kits ist die geringere Ausbeute. Ein schönes Beispiel dazu ist mir auf Next Generation Sequencing untergekommen:
Wow. Ich bin ja gewohnt, nach einer DNA Aufreinigung nur ca. 50% hinten rauszubekommen, aber >99% Verlust? Ich bin sprachlos. 454 gehört zu Roche, und da arbeitet keiner der bezahlt wird, ein Verfahren zu optimieren bevor es auf Kunden losgelassen wird? Ich frage mich gerade, wie viele Leute wohl Geld für fehlgeschlagene 454-Sequenzierungen ausgegeben haben, und der Grund war nur ein Problem mit der Präparation der DNA statt mit der wissenschaftlichen Fragestellung.
Maricic T und Pääbo S (2009): Optimization of 454 sequencing library preparation from small amounts of DNA permits sequence determination of both DNA strands. BioTechniques 46(1):51-57.
(Eigentlich wollte ich gestern abend ja die Paperbesprechung posten, dann habe ich aber ein tolles Rezept für Erdnussbutter-Schoko-Brownies gefunden, das ich lieber austesten wollte. Deshalb kriegt ihr erstmal nur diesen kurzen Post.)
Die Ergebnisse sind in der Regel reproduzierbarer, man muss nicht mehr mit gefährlichen Chemikalien wie Chloroform oder Phenol hantieren, man ist auch schneller fertig.
Das Problem dabei: Gerade weil man nicht mehr selbst mit Chemikalien arbeitet, sondern nur noch fertige Lösungen mit nichtssagenden Namen benutzt, kennen viele Leute nicht die hinter dem Kit stehende Chemie. Es wird halt einfach nach Vorschrift vorgegangen. Ein zweiter Nebeneffekt der Kits ist die geringere Ausbeute. Ein schönes Beispiel dazu ist mir auf Next Generation Sequencing untergekommen:
In the new issue of Biotechniques, a paper by Maricic and Pääbo (login may be required) describes how a change to the standard 454 sequencing protocol can dramatically increase the size of the library of DNA that goes into the actual sequencing reaction.(Hervorhebung von mir.)
The trick used is to replace the last step in the library preparation where single stranded DNA is released from streptavidin beads. The original 454 protocol employes NaOH denaturation for this step, but the researchers found that this procedure results in a loss of over 99% of the DNA. However, When they replaced the NaOH denaturation with a heat denaturation by incubation recovery increased to 98%.
These authors are coming from the ancient DNA community and have an obvious motivation for optimizing the DNA retrieval from scarce ancient biological material. However, these findings are equally important to other applications aimed at sequencing small volumes of biological material such as tumors and within-host sub-populations of pathogens.
Wow. Ich bin ja gewohnt, nach einer DNA Aufreinigung nur ca. 50% hinten rauszubekommen, aber >99% Verlust? Ich bin sprachlos. 454 gehört zu Roche, und da arbeitet keiner der bezahlt wird, ein Verfahren zu optimieren bevor es auf Kunden losgelassen wird? Ich frage mich gerade, wie viele Leute wohl Geld für fehlgeschlagene 454-Sequenzierungen ausgegeben haben, und der Grund war nur ein Problem mit der Präparation der DNA statt mit der wissenschaftlichen Fragestellung.
Maricic T und Pääbo S (2009): Optimization of 454 sequencing library preparation from small amounts of DNA permits sequence determination of both DNA strands. BioTechniques 46(1):51-57.
(Eigentlich wollte ich gestern abend ja die Paperbesprechung posten, dann habe ich aber ein tolles Rezept für Erdnussbutter-Schoko-Brownies gefunden, das ich lieber austesten wollte. Deshalb kriegt ihr erstmal nur diesen kurzen Post.)
Freitag, Januar 02, 2009
sinnfreie Kommentare von Nobelpreisträgern
Es ist ja mittlerweile fast schon ein Merkmal von Nobelpreisträgern, dass sie mit der Annahme des Preises ihr Hirn abgeben und danach nur noch mit unverständlichen Aussagen Schlagzeilen machen. Der bekannteste Vorfall dieser Art in letzter Zeit waren die rassistischen Äußerung von James Watson, die ihn letztlich auch seinen Posten als Direktor des Cold Spring Harbor Laboratory.
Jetzt hat die deutsche Nobelpreisträgerin Christiane Nüsslein-Volhard in einem ZEIT-Interview nachgezogen. Ich konnte davon nur eine kurze Pressemeldung finden, darin stehen aber schon ein paar knackige Sätze.
Kurz zusammengefasst hat Frau Nüsslein-Volhard etwas dagegen, dass so viel DNA sequenziert werde. Genauer gehe das Sequenzieren auf Kosten anderer biologischer Arbeiten, die sie für wichtiger hält. Ich verstehe ja, dass sie ihr Fachgebiet, die Entwicklungsbiologie, für total spannend hält, aber ich konnte nie nachvollziehen, wieso man anderen Gebieten ihre Relevanz absprechen will. DNA wird nicht sequenziert, dass man große Datenbanken mit vier Buchstaben füllen kann - Sequenzen sind die Grundlage für viele weitere Probleme. Unter anderem auch für die Entwicklungsbiologie.
Christiane Nüsslein-Volhard wurde 1995 zusammen mit Edward B. Lewis und Eric F. Wieschaus mit dem Nobelpreis geehrt. Das Thema war hier die Untersuchung der Genetik der Embryonalentwicklung. Die Gene, denen die von Wieschaus und Nüsslein-Volhard untersuchten Entwicklungsmutanten zugrundeliegen, sind heute Modelle für die entsprechenden Gene in anderen Organismen. Warum? Weil wir die Sequenzen dieser Gene kennen, und darüber verwandte Gene finden können!
Nebenbei geht Frau Nüsslein-Volhard in dem ZEIT-Interview auch noch gegen die synthetische Biologie im Allgemeinen, und Craig Venter im Besonderen, an. Jetzt mal ganz von Abneigungen gegen Venter und seinen Methoden abgesehen - ihre Aussage, dass Venter es nicht schaffen wird, einen künstlichen Organismus zu erzeugen, ist mittlerweile als sehr mutig zu bezeichnen. Er hat bereits veröffentlicht, dass er ein gesamtes Genom einer Bakterienart in die Zelle einer anderen Art überführen kann, und dass diese Zelle dann alle Eigenschaften der Spenderart annimmt. In einem zweiten Paper zeigte er, dass die chemische Synthese eines kompletten Genoms möglich ist. Kombiniert man beide Techniken, hat man einen künstlichen Organismus. Und das ist wohl nur noch eine Frage der Zeit.
Interessanterweise benutzt sich hier Frau Nüsslein-Volhard einer Argumentationstechnik, die auch gern von Kreationisten benutzt wird: dem argumentum ad ignorantiam.
"Die Natur ist wahnsinnig gut. So raffiniert, dass wir sie bis heute nicht vollständig verstanden haben."Ich bin mal gespannt, was da im vollständigen Interview noch zum Vorschein kommt.
Mittwoch, Dezember 24, 2008
Weihnachtspaper!
Die Firma DNA 2.0 hat nach dem Weihnachtspaper von 2006 (Santa Claes, Rudolph Reindeer, Saint Nicolas, Ness E. Tomte, Dasher Sridhar, Jeremy Elf (2006): Heterologous expression and functional characterization of the Santa Hoho2 gene. Proc Natl Acad Sci, North Pole 12:25-31. [PDF]) dieses Jahr endlich ein neues weihnachtlich angehauchtes Paper veröffentlicht!
Santa Claes, Feliz Navidad, Tomte Ness E., Ten N. Baum, Hanukkah Harry, Bada Din Sridhar, Jeremy Elf (2008): Metabolic engineering of Picea abies for receptor mediated induction of fluorescence and olfactory signaling. Proc Natl Acad Sci, North Pole 12:25-31. [PDF]
Santa Claes, Feliz Navidad, Tomte Ness E., Ten N. Baum, Hanukkah Harry, Bada Din Sridhar, Jeremy Elf (2008): Metabolic engineering of Picea abies for receptor mediated induction of fluorescence and olfactory signaling. Proc Natl Acad Sci, North Pole 12:25-31. [PDF]
AbstractIn diesem Sinne - ich wünsche euch allen Frohe Weihnachten! Und versucht mal, euren Baum anzusingen, vielleicht habt ihr ja eins dieser transgenen Exemplare bei euch stehen!
Reoccurring seasonal harvesting of Picea abies (Norwegian spruce) and the subsequent attachment of light fixtures to the tree followed by composting after only 3 weeks of minimal use is not only a waste but also leads to diminishing spruce forests, release of carbon dioxide, global warming, increased energy consumption and a political burden to the ongoing diplomatic efforts of Santa Claus. We here present a synthetic biology solution to address this key concerns for winter celebrations – A song induced Christmas tree with endogenous light and odor emission. Advances in synthetic biology, tissue engineering and metabolic engineering have now provided new insights and techniques for controlling whole organism signaling and bio-compound production in situ, and recent efforts in synthetic biology have demonstrated that complex regulatory and metabolic networks can be designed and engineered in microorganisms and simple eukaryotes. Leading researchers at the NorthPole Bioscience Engineering Council here disclose how sonic-induced signals received through tissue engineered tympanal organs are incorporated into regulating the metabolic distribution of fluorescent and olfactory signals in Picea abies. Upon induction, the cellular nodality of the tree branches emit light at predefined wavelength due to engineered luciferases mTwinkie (yellow), mWonderbread (white) and mSnoBalls (pink). The synthetic induction system also triggers the production and emission of seasonal olfactory signals including trans-cinnamaldehyde (cinnamon), 6-gingerol (ginger), and methyl salicylate (mint). The synthetic pathway is hereby denoted xmas1.
Ein nettes vorgezogenes Weihnachtsgeschenk
Nach Monaten von Warten kam letzten Freitag endlich das neueste Paper unseres Instituts raus - und ich bin einer der Mitautoren (Wenn auch nicht der Erstautor, was ich auf jeden Fall betonen will.)! Das ist zwar nicht mein erstes Paper [1], aber an dieser Arbeit war ich während meiner Diplomarbeit beteiligt und bin es auch aktuell während meiner Doktorarbeit.
Da der Artikel bei PLoS Genetics erschienen ist, kann ihn jeder kostenlos lesen, also super für Open Access! Spannend an der Geschichte ist auch, dass wir den Artikel back-to-back mit einem zweiten Paper der Gruppe von Mathilde Grelon aus Versailles veröffentlicht haben. Deren Ergebnisse ergänzen sich sehr gut mit unseren, so dass PLoS Genetics sogar noch nen Perspective-Artikel dazu hat schreiben lassen.
Ich bin jetzt gerade ein wenig unentschlossen, wie ich hier weitermachen soll. Einerseits halte ich das Thema für sehr interessant und spannend (natürlich!), andererseits kommt es mir aber extrem merkwürdig vor, über eigene Arbeiten zu schreiben. Wäre das nicht ein wenig wie Werbung? Haltet ihr mich für objektiv genug, oder sieht das dann so aus, als wollte ich unsere Daten in ein positiveres Licht rücken? Ich werd also eine kleine Umfrage in die Seitenleiste stellen, dann dürft ihr das entscheiden!
Hartung F, Suer S, Knoll A, Wurz-Wildersinn R, Puchta H (2008): Topoisomerase 3α and RMI1 Suppress Somatic Crossovers and Are Essential for Resolution of Meiotic Recombination Intermediates in Arabidopsis thaliana. PLoS Genet 4(12): e1000285.
[1] Darüber hatte ich vergessen zu berichten, das erste Paper bei dem ich Mitautor bin kam im Oktober raus. Mein Anteil an der Veröffentlichung geht noch auf ein längeres Praktikum während des Studiums zurück, am Institut für Rebenzüchung in Siebeldingen in der Südpfalz, einer Einrichtung des Julius-Kühn-Instituts (Bundesforschungsinstitut für Kulturpflanzen).
Kortekamp A, Welter L, Vogt S, Knoll A, Schwander F, Töpfer R, Zyprian E (2008): Identification, isolation and characterization of a CC-NBS-LRR candidate disease resistance gene family in grapevine. Molecular Breeding 22(3):421-432.
Montag, Dezember 15, 2008
Zurück aus Wien
Seit ein paar Tagen bin ich wieder zurück von meinem 2wöchigen Trip nach Wien. Und neben vielen schönen Erinnerungen und Erfahrungen aus der Gruppe von Karel Riha am Gregor-Mendel-Institut, deren Mitglieder viel Zeit geopfert haben, um mir neue Methoden beizubringen (die sogar gleich in ein paar sehr interessanten Daten resultierten!), habe ich die Zeit genutzt und so viel wie möglich von der Stadt angesehen. Ein paar der Bilder habe ich zu Picasa hochgeladen, sie sind hier zu finden [1]:
Wenn ich nun schon in Wien war, wollte ich natürlich auch mal die Science Busters sehen. Da gab es nur ein Problem: die waren für mehr Vorstellungen ausverkauft, als ich in Wien sein würde! Glücklicherweise hatten die Kollegen vom GMI (liebe Grüße, falls das jemand von euch liest!) schon vorbestellt, und eine Karte wurde frei. So saß ich dann doch noch zum Thema "Geheimnisvolles Universum Reloaded: Vom Urknall bis zum Multiversum" in der zweiten Reihe und genoss die Show - extrem empfehlenswert!
Hin und zurück war ich übrigens auch per Zug unterwegs. Nicht, weil es günstiger gewesen wäre. Mit dem Flugzeug hätte die Reise nicht mal halb so lange gedauert, und wäre auch nur ungefähr halb so teuer gewesen. Was macht man aber nicht alles für die Wissenschaft - ich hatte auf dem Hinweg jede Menge DNA dabei, und auf dem Rückweg zusätzlich noch Membranen von Southern Blots. Die darf ich zwar problemlos und ganz legal transportieren, aber wer riskiert heutzutage denn die Arbeit von Monaten bis Jahren an einer Sicherheitskontrolle im Flughafen ("Sorry, aber das dürfen sie nicht mitnehmen. Werfen sie es bitte da hinten in die schwarze Tonne.") Gerade bei den Membranen hätte das heikel werden können. Die bestehen nämlich aus Nitrocellulose, und da springen wahrscheinlich die Sprengstoffdetektoren drauf an :D
[1] Als Biologe konnte ich natürlich nicht anders, es sind auch jede Menge Bilder von Tieren dabei.
 |
| Wien 081123-081208 |
Wenn ich nun schon in Wien war, wollte ich natürlich auch mal die Science Busters sehen. Da gab es nur ein Problem: die waren für mehr Vorstellungen ausverkauft, als ich in Wien sein würde! Glücklicherweise hatten die Kollegen vom GMI (liebe Grüße, falls das jemand von euch liest!) schon vorbestellt, und eine Karte wurde frei. So saß ich dann doch noch zum Thema "Geheimnisvolles Universum Reloaded: Vom Urknall bis zum Multiversum" in der zweiten Reihe und genoss die Show - extrem empfehlenswert!
Hin und zurück war ich übrigens auch per Zug unterwegs. Nicht, weil es günstiger gewesen wäre. Mit dem Flugzeug hätte die Reise nicht mal halb so lange gedauert, und wäre auch nur ungefähr halb so teuer gewesen. Was macht man aber nicht alles für die Wissenschaft - ich hatte auf dem Hinweg jede Menge DNA dabei, und auf dem Rückweg zusätzlich noch Membranen von Southern Blots. Die darf ich zwar problemlos und ganz legal transportieren, aber wer riskiert heutzutage denn die Arbeit von Monaten bis Jahren an einer Sicherheitskontrolle im Flughafen ("Sorry, aber das dürfen sie nicht mitnehmen. Werfen sie es bitte da hinten in die schwarze Tonne.") Gerade bei den Membranen hätte das heikel werden können. Die bestehen nämlich aus Nitrocellulose, und da springen wahrscheinlich die Sprengstoffdetektoren drauf an :D
[1] Als Biologe konnte ich natürlich nicht anders, es sind auch jede Menge Bilder von Tieren dabei.
Donnerstag, November 13, 2008
IBMP recap #1: DNA recombination
Mit mehr Verspätung als geplant fange ich also endlich mit der Zusammenfassung der Vorträge vom diesjährigen IBMP-Kolloquium "Integrative Plant Biology" an.
In der ersten Session ging es um DNA-Rekombination, also den Prozess, der Sequenzen zwischen zwei DNA-Molekülen austauscht. Einer der Sprecher war mein Chef, Holger Puchta, und über unsere Arbeiten werde ich demnächst sowieso noch schreiben, also spar ich mir das hier.
Der zweite Vortrag war von Barbara Hohn und befasste sich mit dem Einfluss der Umwelt auf die Genomdynamik, also all die vielen Prozesse, die den Zustand der DNA im Zellkern auf eine globale Weise regulieren. Klassischerweise sieht man den Einfluss der Umwelt auf die Evolution während der Selektion der Nachkommen. Nach den Ergebnissen von Barbara Hohn kann die Natur aber schon während dem Leben der Eltern auf vielfältige Weise die Rekombinationsrate beeinflussen, und dadurch eben auch neue Genkombinationen für die Evolution erzeugen.
Zur Messung der Rekombinationsrate wurden in ihrer Gruppe mehrere Reporterlinien erzeugt, die wir bei uns auch verwenden. Während aber wir mit diesen Reporterlinien die Rekombinationsrate zwischen Wildtyp und verschiedenen knockout-Mutanten vergleichen, um Gene finden zu können, die in die Rekombination involviert sind, will Barbara Hohn äußere Einflussfaktoren der Rekombination bestimmen.
Und davon gibt es jede Menge, die auch recht interessant sind: Ozon blockt UV-Strahlen, die in die Atmosphäre eindringen. Die Dosis UV-Strahlung, die ein Organismus abkriegt, hängt demnach von der Menge an Ozon in der Atmosphäre, und von dessen Höhe ab (mehr UV auf dem Berg als im Tal). Erhöhte UV-B Strahlung resultiert jedoch in einer erhöhten Rekombinationsrate.
Auch ein Pathogenbefall führt zu mehr Rekombination. Hier konnte außerdem gezeigt werden, dass es ein Signal geben muss, das die Rekombinationsrate hochreguliert. Wenn man beispielsweise ein Tabakblatt mit dem Tabakmosaikvirus infiziert, dann breitet dieses sich über Stunden bis Tage in der restlichen Pflanze aus, und man kann die Ausbreitung visuell mitverfolgen. Die Rekombinationsrate ist nicht nur im infizierten Gewebe erhöht, sondern immer auch in benachbarten Geweben, die nicht infiziert sind - es muss also ein Signal geben, das durch die Pflanze transportiert wird (schneller als das Virus), und die restlichen Zellen schon mal "vorwarnt".
Logisch erscheint eigentlich, dass ionisierende Strahlung, die Brüche in der DNA hervorruft, zu einer Erhöhung der Rekombinationsrate führt. Es ist jedoch richtig clever, wie dies mit den Reporterlinien von Barbara Hohn genutzt wird: Sie dienen nämlich in den Gebieten um Tschernobyl als Biomarker für die Strahlung aus der kontaminierten Erde. Die Reporterlinien sind nämlich so sensitiv, dass man sehr gut über die unterschiedlichen Rekombinationsraten an verschiedenen Orten auf die Hintergrundstrahlung vor Ort schließen kann.
Bis zum Schluss habe ich mir die meiner Meinung nach interessanteste Beobachtung von Barbara Hohns Forschung aufgehoben. Pflanzen haben eine "Erinnerung" an Stressfaktoren über mehrere Generationen hinweg! Dies wurde eher durch Zufall entdeckt. Bestrahlt man die Reporterlinien mit UV-B Strahlung, führt dies zu einer Erhöhung der Rekombinationsrate, wie ich oben ja schon beschrieben habe. Man findet jedoch auch eine erhöhte Rekombinationsrate in mehreren Generationen von Nachkommen dieser bestrahlten Pflanzen, die selbst nie bestrahlt wurden! Dieser Effekt ist auch mit anderen Induktoren der Rekombination reproduzierbar. Noch besser - auch wenn nur ein Elternteil mit UV-B bestrahlt wird, und nur ein Elternteil das Reporterkonstrukt trägt, haben die Nachkommen in allen möglichen Kombinationen dieser Zustände erhöhte Rekombinationsraten. Es ist bis jetzt noch nicht klar, was zu diesem Effekt führt. Die wahrscheinlichste Erklärung ist ein epigenetischer Effekt. Es handelt sich also nicht um Mutationen oder ähnliche Veränderungen der DNA-Sequenz, sondern Veränderungen der DNA-Struktur, die Bereiche zugänglicher oder weniger zugänglich für Prozesse wie die Rekombination machen. Ein ähnlicher Effekt konnte auch in Mäusen beschrieben werden, er scheint also auch in Tieren eine Rolle zu spielen.
Damit ist die erste Session abgeschlossen, im nächsten Teil geht es um Signalwege mit einer Rolle in Entwicklung und Pathogenabwehr.
Jean Molinier, Gerhard Ries, Cyril Zipfel, Barbara Hohn (2006). Transgeneration memory of stress in plants Nature, 442 (7106), 1046-1049 DOI: 10.1038/nature05022
R C Barber, P Hickenbotham, T Hatch, D Kelly, N Topchiy, G M Almeida, G D D Jones, G E Johnson, J M Parry, K Rothkamm, Y E Dubrova (2006). Radiation-induced transgenerational alterations in genome stability and DNA damage Oncogene, 25 (56), 7336-7342 DOI: 10.1038/sj.onc.1209723
Mittwoch, November 12, 2008
Von Bodensatz und Hochstaplern
Hier soll es um einen Ausdrucksfehler gehen, der mich in letzter Zeit immer öfter aufregt. Vor allem, weil er auch von einer ganzen Menge Leuten gemacht wird, die es eigentlich besser wissen sollten. Was ich meine? Die allseits verbreitete Unart, in biologischen Texten von "höheren" und "niederen" Organismen/Eukaryoten/Tieren/Pflanzen/etc. zu sprechen (entsprechend im Englischen "higher" und "lower"). Denn auch die ständige Verwendung dieser Begriffe ändert nichts daran, dass es diese zwei Gruppierungen schlicht nicht gibt, und dass sie schlimmer noch ein stark verzerrtes Bild der tatsächliches Verwandtschaft von Organismen zeichnen.
Ein Beispiel, wie ich es auch in Fachartikeln immer wieder lese, geht in etwa so: "Wir haben Gen/Protein X in der Maus untersucht und es hat Funktion Y. Da wir es über Sequenzvergleiche auch im Menschen, aber nicht in der Fruchtfliege Drosophila melanogaster finden, ist diese beschriebene Funktion den höheren Tieren vorbehalten, niedere Tiere müssen ohne Auskommen."
Hier wird willkürlich eine Grenze in den Tieren gezogen, die üblicherweise bei den Wirbeltieren liegt. Gehört der Organismus zur Gruppe der Wirbeltiere, ist es ein "höheres" Tier, wenn nicht, dann ist es ein "niederes" Tier. In diesem Fall ist die Unterscheidung zumindest noch soweit vertretbar, dass es innerhalb der Tiere wirklich ein Taxon "Wirbeltiere" (Vertebrata) gibt - aber wieso grenzen die Autoren dann die zwei Gruppen nicht mit dem etablierten Fachbegriff ab? Denn ein Problem mit der Verwendung von "höheren" und "niederen" Organismen wird schon in diesem einfachen Beispiel sichtbar: Die "höheren" Tiere stehen in einer angenommenen Rangfolge über den "niederen" Tieren. Dies geht auf eine veraltete und lange widerlegte Sicht der Verhältnisse der Organismen zurück, die beispielsweise auch Linné noch teilte: die scala naturae, die eine hierarchische Rangfolge aller Objekte im Universum postuliert. Demnach stehen ganz unten unbelebte Dinge wie Steine, darauf folgen Pflanzen, die ja schon leben. Wichtiger als Pflanzen sind Tiere, da sie sich auch bewegen können. Der Mensch bildet die Krone der Schöpfung, und ganz oben sitzt Gott. Demnach kann man verstehen, warum die Wirbeltiere höher als Invertebraten stehen sollen - der Mensch ist auch ein Wirbeltier. Das Problem daran: Wir wissen aus verschiedenen Quellen, dass alle heute lebenden Organismen auf einen einzigen gemeinsamen Vorfahren zurückgehen. Das bedeutet aber im Umkehrschluss, dass alle dieser heute lebenden Organismen gleich "alt" sind und die Evolution gleich lange auf ihre Vorfahren gewirkt hat. Was ganz sicher nicht stimmt ist, dass die heute lebenden Organismen verschiedene Stufen auf einer Leiter sind, die zum Menschen hinführt. Auch das Argument der unterschiedlichen Komplexität der Organismen zieht nicht, weil alle Organismen prinzipiell bestangepasst für ihren aktuellen Lebensraum sind. Wenn dieser Lebensraum eine einzellige Lebensweise bevorzugt, dann sagt das verständlicherweise nichts über einen möglichen Stand es darin lebenden Organismus in der Rangfolge des Lebens aus.
Die Sichtweise der scala naturae für eine Unterscheidung in "höhere" und "niedere" Tiere ist also nicht haltbar. Warum es mit der inflationären Verwendung dieser Begriffe aber noch ein anderes Problem gibt, möchte ich auch kurz anreißen. Wenn wir den Blick nämlich ein wenig weiter als nur die Tiere schweifen lassen, wird offensichtlich, dass viele Autoren über die Verwandtschaftsverhältnisse der Organismengruppen hier auf der Erde nicht viel Ahnung haben, oder dass sie ihnen zumindest zum Zweck eines einfachen Arguments egal sind. Hin und wieder kommt es nämlich vor, dass in Fachartikeln auch Organismen außerhalb der Tiere in den Vergleich einbezogen werden. Meistens handelt es sich dabei um den klassischen eukaryotischen Modellorganismus, die einzellige Bäckerhefe Saccharomyces cerevisiae. Noch seltener werden auch Pflanzen mit untersucht. Wenn das passiert, dann ist der Grimassenfaktor bei der Diskussion von "höheren" und "niederen" Eukaryoten aber besonders hoch:
Sehr oft findet man im Vergleich von mehrzelligen Tieren und mehrzelligen Pflanzen genetische Gemeinsamkeiten, die in vielen einzelligen Eukaryoten, egal ob Tier, Pilz oder Pflanze, nicht zu finden sind. Darum sprechen diese Leute dann von "höheren" Eukaryoten und meinen Organismen wie den Menschen, die Maus, Reis, Mais und Arabidopsis, und von "niederen" Eukaryoten und meinen dann die einzellige Alge Chlamydomonas rheinhardtii, die Bäckerhefe, eine der Amöben mit durchsequenziertem Genom, etc. Hier tritt nun ein großes Problem auf, das in dem Beispiel oben mit der Unterscheidung von zwei großen Tiergruppen (Vertebraten - Invertebraten) noch nicht vorhanden war. Es werden Verwandtschaftsgruppen zwischen Organismen gebildet, die keineswegs so direkt miteinander verwandt sind.
Beispiel Maus und Arabidopsis. Um den gemeinsamen Vorfahren von der Maus und Arabidopsis zu finden, muss ich von beiden Organismen aus immer die nächstverwandten Arten zu Gruppen zusammenfassen, bis ich schließlich eine Organismenmenge habe, die sowohl Maus, als auch Arabidopsis beinhaltet. Dabei lande ich von der Maus aus (in großen Sprüngen) über Nagetiere, Wirbeltiere, Bilateria, Tiere (Metazoa), Tiere/Pilze bei einem ursprünglichen Eukaryoten, der mit sehr großer Wahrscheinlichkeit einzellig war. Von Arabidopsis aus kommt man ebenfalls zu diesem ursprünglichen Organismus. Auf dem dorthin begegne ich aber jeder Menge "niederer" Eukaryoten! Wie gesagt, Wirbeltiere und Samenpflanzen sind nicht direkt miteinander verwandt...
Ich denke, das wird auch aus dieser Abbildung hier sehr deutlich. Die "höheren" Eukaryoten sollen jeweils ein Teil (!) der beiden rot eingekreisten Taxa sein, der Rest darf sich "niederer" Eukaryot schimpfen.

Und es ist mittlerweile dringend nötig, nicht mehr von "höheren" und "niederen" Organismen zu sprechen. Wenn Studenten Vorträge halten oder Texte verfassen, verwenden sie diese Begriffe natürlich gern, weil sie so griffig sind. Als Betreuer darf man dann immer darauf hinweisen, dass diese Begriffe nicht korrekt sind. Was in großen, ungläubigen Augen seitens der Studenten resultiert, schließlich stand das ja so in zig Papern, die sie gelesen haben...Letzten Endes erziehen wir uns durch die falsche Verwendung dieser beiden Worte also eine Generation von Wissenschaftlern, die sie schon aus dem Studium kennen und darum noch unkritischer verwenden werden. Dem tatsächlichen Verständnis beispielsweise von Proteinfunktionen zwischen verschiedenen Organismen tut das aber sicher keinen Gefallen!
Ein Beispiel, wie ich es auch in Fachartikeln immer wieder lese, geht in etwa so: "Wir haben Gen/Protein X in der Maus untersucht und es hat Funktion Y. Da wir es über Sequenzvergleiche auch im Menschen, aber nicht in der Fruchtfliege Drosophila melanogaster finden, ist diese beschriebene Funktion den höheren Tieren vorbehalten, niedere Tiere müssen ohne Auskommen."
Hier wird willkürlich eine Grenze in den Tieren gezogen, die üblicherweise bei den Wirbeltieren liegt. Gehört der Organismus zur Gruppe der Wirbeltiere, ist es ein "höheres" Tier, wenn nicht, dann ist es ein "niederes" Tier. In diesem Fall ist die Unterscheidung zumindest noch soweit vertretbar, dass es innerhalb der Tiere wirklich ein Taxon "Wirbeltiere" (Vertebrata) gibt - aber wieso grenzen die Autoren dann die zwei Gruppen nicht mit dem etablierten Fachbegriff ab? Denn ein Problem mit der Verwendung von "höheren" und "niederen" Organismen wird schon in diesem einfachen Beispiel sichtbar: Die "höheren" Tiere stehen in einer angenommenen Rangfolge über den "niederen" Tieren. Dies geht auf eine veraltete und lange widerlegte Sicht der Verhältnisse der Organismen zurück, die beispielsweise auch Linné noch teilte: die scala naturae, die eine hierarchische Rangfolge aller Objekte im Universum postuliert. Demnach stehen ganz unten unbelebte Dinge wie Steine, darauf folgen Pflanzen, die ja schon leben. Wichtiger als Pflanzen sind Tiere, da sie sich auch bewegen können. Der Mensch bildet die Krone der Schöpfung, und ganz oben sitzt Gott. Demnach kann man verstehen, warum die Wirbeltiere höher als Invertebraten stehen sollen - der Mensch ist auch ein Wirbeltier. Das Problem daran: Wir wissen aus verschiedenen Quellen, dass alle heute lebenden Organismen auf einen einzigen gemeinsamen Vorfahren zurückgehen. Das bedeutet aber im Umkehrschluss, dass alle dieser heute lebenden Organismen gleich "alt" sind und die Evolution gleich lange auf ihre Vorfahren gewirkt hat. Was ganz sicher nicht stimmt ist, dass die heute lebenden Organismen verschiedene Stufen auf einer Leiter sind, die zum Menschen hinführt. Auch das Argument der unterschiedlichen Komplexität der Organismen zieht nicht, weil alle Organismen prinzipiell bestangepasst für ihren aktuellen Lebensraum sind. Wenn dieser Lebensraum eine einzellige Lebensweise bevorzugt, dann sagt das verständlicherweise nichts über einen möglichen Stand es darin lebenden Organismus in der Rangfolge des Lebens aus.
Die Sichtweise der scala naturae für eine Unterscheidung in "höhere" und "niedere" Tiere ist also nicht haltbar. Warum es mit der inflationären Verwendung dieser Begriffe aber noch ein anderes Problem gibt, möchte ich auch kurz anreißen. Wenn wir den Blick nämlich ein wenig weiter als nur die Tiere schweifen lassen, wird offensichtlich, dass viele Autoren über die Verwandtschaftsverhältnisse der Organismengruppen hier auf der Erde nicht viel Ahnung haben, oder dass sie ihnen zumindest zum Zweck eines einfachen Arguments egal sind. Hin und wieder kommt es nämlich vor, dass in Fachartikeln auch Organismen außerhalb der Tiere in den Vergleich einbezogen werden. Meistens handelt es sich dabei um den klassischen eukaryotischen Modellorganismus, die einzellige Bäckerhefe Saccharomyces cerevisiae. Noch seltener werden auch Pflanzen mit untersucht. Wenn das passiert, dann ist der Grimassenfaktor bei der Diskussion von "höheren" und "niederen" Eukaryoten aber besonders hoch:
Sehr oft findet man im Vergleich von mehrzelligen Tieren und mehrzelligen Pflanzen genetische Gemeinsamkeiten, die in vielen einzelligen Eukaryoten, egal ob Tier, Pilz oder Pflanze, nicht zu finden sind. Darum sprechen diese Leute dann von "höheren" Eukaryoten und meinen Organismen wie den Menschen, die Maus, Reis, Mais und Arabidopsis, und von "niederen" Eukaryoten und meinen dann die einzellige Alge Chlamydomonas rheinhardtii, die Bäckerhefe, eine der Amöben mit durchsequenziertem Genom, etc. Hier tritt nun ein großes Problem auf, das in dem Beispiel oben mit der Unterscheidung von zwei großen Tiergruppen (Vertebraten - Invertebraten) noch nicht vorhanden war. Es werden Verwandtschaftsgruppen zwischen Organismen gebildet, die keineswegs so direkt miteinander verwandt sind.
Beispiel Maus und Arabidopsis. Um den gemeinsamen Vorfahren von der Maus und Arabidopsis zu finden, muss ich von beiden Organismen aus immer die nächstverwandten Arten zu Gruppen zusammenfassen, bis ich schließlich eine Organismenmenge habe, die sowohl Maus, als auch Arabidopsis beinhaltet. Dabei lande ich von der Maus aus (in großen Sprüngen) über Nagetiere, Wirbeltiere, Bilateria, Tiere (Metazoa), Tiere/Pilze bei einem ursprünglichen Eukaryoten, der mit sehr großer Wahrscheinlichkeit einzellig war. Von Arabidopsis aus kommt man ebenfalls zu diesem ursprünglichen Organismus. Auf dem dorthin begegne ich aber jeder Menge "niederer" Eukaryoten! Wie gesagt, Wirbeltiere und Samenpflanzen sind nicht direkt miteinander verwandt...
Ich denke, das wird auch aus dieser Abbildung hier sehr deutlich. Die "höheren" Eukaryoten sollen jeweils ein Teil (!) der beiden rot eingekreisten Taxa sein, der Rest darf sich "niederer" Eukaryot schimpfen.

(aus Keeling PJ et al. 2005, Trends in Ecology & Evolution)Also, um zusammenzufassen: Die Unterscheidung von "höheren" und "niederen" Organismen macht aus vielen Gründen keinen Sinn, sie ist sogar irreführend. Ich kann verstehen, dass ein Autor gerne seine Ergebnisse übersichtlich vergleichen möchte. Aber wieso werden dann nicht Bezeichnungen verwendet, die nicht so problematisch sind? Dazu muss man sich fragen: Was unterscheidet Samenpflanzen und Wirbeltiere von den meisten anderen Eukaryoten? Sie sind mehrzellige Organismen, während praktisch alle Gruppen in der Abbildung oben ohne roten Kreis Einzeller sind. Dieser Unterschied hat verständlicherweise einen großen Einfluss auf die Lebensweise des Organismus - es wundert also nicht, dass die "höheren" Eukaryoten zu ähnlichen Problemen - der mehrzelligen Lebensweise - ähnliche Lösungen gefunden haben. Um unser Problem zu lösen reicht meiner Meinung nach eben, wenn man jedes "höhere" und "niedere" durch einzellige und mehrzellige ersetzen würde.
Und es ist mittlerweile dringend nötig, nicht mehr von "höheren" und "niederen" Organismen zu sprechen. Wenn Studenten Vorträge halten oder Texte verfassen, verwenden sie diese Begriffe natürlich gern, weil sie so griffig sind. Als Betreuer darf man dann immer darauf hinweisen, dass diese Begriffe nicht korrekt sind. Was in großen, ungläubigen Augen seitens der Studenten resultiert, schließlich stand das ja so in zig Papern, die sie gelesen haben...Letzten Endes erziehen wir uns durch die falsche Verwendung dieser beiden Worte also eine Generation von Wissenschaftlern, die sie schon aus dem Studium kennen und darum noch unkritischer verwenden werden. Dem tatsächlichen Verständnis beispielsweise von Proteinfunktionen zwischen verschiedenen Organismen tut das aber sicher keinen Gefallen!
Abonnieren
Posts (Atom)

 Posts