Posts mit dem Label Open Access werden angezeigt. Alle Posts anzeigen

Montag, März 02, 2009

Projekt Paperübersicht Intermezzo: Homologe Rekombination

ResearchBlogging.orgWährend es im letzten Post um den Reparatur-Aspekt unserer Mutanten ging, soll im nächsten deren Beteiligung an der DNA-Rekombination betrachtet werden. Doch das wird ohne ein wenig Hintergrundwissen zur homologen Rekombination nicht so leicht werden, deshalb habe ich mich für diesen hoffentlich nicht zu komplexen Einschub entschieden.


Rekombination bedeutet zunächst, dass genetische Information zwischen zwei DNA-Molekülen ausgetauscht wird. Von den vielen Rekombinationsmechanismen ist die homologe Rekombination der konservativste. Das war jetzt keine politische Aussage, es bedeutet nur, dass es dabei idealerweise zu keiner Änderung der Sequenz kommt. Dies ist möglich, weil für die homologe Rekombination identische (= homologe) DNA-Sequenzen verwendet werden. Diese Sequenzen kommen bei diploiden Organismen wie dem Menschen oder Arabidopsis vom homologen Chromosom. Oder, noch besser, nach der Verdopplung der Chromosomen während der Replikation, vom Schwesterchromatid. Ausgangspunkt der homologen Rekombination ist immer ein Doppelstrangbruch. Dieser kann gewollt sein, etwa in der Meiose (dazu in einem anderen Teil der Paperübersicht mehr, wahrscheinlich #5). Alternativ kann ein Doppelstrangbruch aber auch durch ionisierende Strahlung oder Chemikalien ausgelöst werden. Dies wäre dann die Verbindung der homologen Rekombination mit der DNA-Reparatur.

Was wirklich während der homologen Rekombination passiert, wissen wir noch nicht hundertprozentig. Man kann diesen vorgang nicht live an einem DNA-Molekül mitverfolgen. Man kann aber seine Versuche so aufbauen, dass bestimmte Abläufe aufgrund des Ergebnisses ausgeschlossen werden können, andere Abläufe aber wahrscheinlicher werden. Viele solcher grundlegenden Experimente wurden mit der Bäckerhefe Saccharomyces cerevisiae gemacht, bei der clever definierte Konstrukte in das Genom eingebracht wurden, die nach einer homologen Rekombination erlauben, Anteile von bestimmten Vorgängen zu ermitteln. Das hört sich jetzt sehr nichtssagend an, deshalb will ich kurz an einem schönen Beispiel zeigen was ich damit meine.

Das "Double Strand Break Repair" Modell der homologen Rekombination
1983 fassten Szostak et al. in einem Review-Artikel den damals aktuellen Stand der Rekombinationsforschung zusammen. Dabei stellten sie fest, dass bisher vorgeschlagene Modelle der homologen Rekombination selten auftrende Ereignisse während der Meiose nicht vorhersagen konnten. Wenn man beispielsweise zwei Marker betrachtet [1], die heterozygot und gekoppelt vorliegen (also gemeinsam auf einem Chromosom sitzen, aber nicht auf dem zweiten Chromosom eines diploiden Organismus), dann erwartet man in den Nachkommen die einfache Aufspaltung nach Mendel in 1:1 - eine Hälfte der Nachkommen hat das Chromosom mit beiden Markern erhalten, die andere Hälfte das homologe Chromosom ohne die Marker. Aufgrund der besonderen Chromosomensituation der damals untersuchten Pilzarten ist die Notation hier traditionellerweise nicht 1:1, sondern 4:4, das ändert am Verhältnis aber nichts. Man kann nun aber beobachten, dass manchmal auch andere Aufteilungen passieren, beispielsweise 6:2 (bzw. 2:6), oder auch 5:3. Hier muss Information von einem Chromosom auf ein anderes übertragen worden sein, oder ein Austausch zwischen zwei Chromosomen erfolgt sein, so dass die beiden Marker nicht mehr gekoppelt auf einem Chromosom vorliegen und unabhängig voneinander vererbt werden können. Diese beiden Vorgänge bezeichnet man als gene conversion und crossing over, und sie sind in Abbildung 1 aus Szostak et al. dargestellt (wenn auch in umgekehrter Reihenfolge):

Abbildung 1 aus Szostak et al. (1983). Zustand von zwei gekoppelten heterozygoten Markern A und B und die Effekte von crossing over (a) und gene conversion (b). Klicken für größere Version.

Woran liegt das nun? Szostak et al. schlagen einen Mechanismus vor, der auf der Reparatur von Doppelstrangbrüchen beruht. Dies war neu, denn die bisherigen Modelle gingen von Auslösern wie kurzen einzelsträngigen Bereichen auf der DNA (ssDNA nicks) aus. Von der Reparaturforschung war damals bereits bekannt, dass die Doppelstrangbruchreparatur in der Bäckerhefe sehr effizient ablief. Das neue Modell sollte also mit Doppelstrangbrüchen beginnen, und mit der Möglichkeit für sowohl crossing over, als auch gene conversion enden. Die Idee von Szostak und Kollegen sah folgendermaßen aus:

Doppelstrangbruchreparatur Modell (DSBR) nach Szostak et al. (1983). Klicken für größere Version.

Ausgehend von einem Doppelstrangbruch werden die freien Enden durch Proteine (Exonukleasen) so zurückgeschnitten, dass freie einzelsträngige Überhänge vorliegen. So eine ssDNA ist dann natürlich verfügbar für Basenpaarungen. Wenn nach einer "Homologiesuche" eine homologe DNA-Sequenz gefunden wird (die wie gesagt beispielsweise auf dem homologen Chromosom, oder auch dem Schwesterchromatid liegen kann), dann erfolgt die sogenannte Einzelstranginvasion: Der Einzelstrang lagert sich an die komplementäre Sequenz an und verdrängt dabei einen der vorhandenen Stränge. Die daraus resultierende Struktur wird D-Loop (displacement loop) genannt. Von hier an kann das freie Ende mit Hilfe einer DNA-Polymerase verlängert werden, was den D-Loop vergrößert. Irgendwann ist ein so großer Bereich DNA im D-Loop verdrängt, dass dieser mit dem zweiten freien Ende des Doppelstrangbruches paaren kann. Dies bedeutet auch, dass das erste freie Ende endlich mit der anderen Seite des Doppelstrangbruches verknüpft werden kann. Der DSB ist jetzt zwar repariert, aber wir haben nun eine problematische DNA-Struktur vorliegen - zwei DNA-Moleküle sind an zwei Positionen überkreuzt. So eine kreuzförmige DNA-Struktur nennt man übrigens nach ihrem Erstbeschreiber Holliday Junction (AHA!), bei den zwei Überkreuzungen hier spricht man von einer doppelten Holliday Junction (dHJ). Warum ist diese Struktur problematisch? Weil eine Zelle sich nicht teilen kann, bevor die dHJ aufgelöst wurde!
Und jetzt greift die Idee von Jack Szostak und Kollegen. Eine Endonuklease, also ein Protein das im Inneren eines DNA-Moleküles schneidet, kann an den Holliday Junctions Schnitte setzen, um die zwei Stränge voneinander zu trennen. Und abhängig davon, ob die beiden Schnitte symmetrisch (unten links) oder asymmetrisch (unten rechts) erfolgen, erhält man entweder ein crossing over (CO, rechts) oder eine gene conversion (auch noncrossover genannt, also NCO, links).

Seit 1983 ist viel Zeit vergangen, doch das DSBR-Modell hat sich gehalten. Mittlerweile wurde etwa gezeigt, dass in der Meiose ein spezielles Protein absichtlich Doppelstrangbrüche zur Einleitung der homologen Rekombination setzt: SPO11. Auch Holliday Junctions wurden bereits als Intermediate der Rekombination experimentell nachgewiesen.

"Synthesis-dependent strand-annealing" und das "revised model"
Um es jetzt noch ein wenig komplizierter zu machen, will ich der Vollständigkeit halber das Bild auf den aktuellen Stand bringen. Als 1994 die Gruppen von William Engels und Gregory Gloor (Nassif et al., 1994) Rekombinationsexperimente mit der Fruchtfliege Drosophila melanogaster machten, stießen sie auf Ergebnisse, die sich mit dem DSBR-Modell von Szostak et al. nicht vollständig erklären ließen. Letzen Endes waren ihre Ergebnisse nur zu verstehen, wenn man beiden freien Enden des DSB erlaubte, unabhängig voneinander die Rekombination mit verschiedenen Partnern einzuleiten. Eine Auflösung nach ihrem synthesis-dependent strand-annealing-Modell (SDSA) benötigte demnach keine Holliday Junction als Intermediat. Bereits nach Verlängerung des ersten freien Endes würde dieses aus dem D-Loop geworfen und für die Basenpaarung mit dem zweiten Ende zur Verfügung stehen. Durch solch einen Mechanismus wären keine Crossoverprodukte möglich.
2001 wurden die beiden konkurrierenden Modelle DSBR und SDSA dann gleichzeitig von zwei Gruppen zusammengefasst. In dem heute als revised model bezeichneten Prozess nach in der Bäckerhefe gewonnenen Ergebnissen von Hunter und Kleckner (2001) und Allers und Lichten (2001) beginnt die homologe Rekombination zunächst, wie ich es schon für DSBR und SDSA beschrieben habe. Die Aufteilung in die beiden Arme CO und NCO erfolgt jedoch schon vor dem dHJ-Intermediat, nämlich auf Ebene des D-Loop. Von hier ab kann dann die Rekombination entweder zum NCO aufgelöst werden, per SDSA-Modell. Oder eben über die doppelte Holliday Junction zum CO, das nach diesem Modell das einzige Ergebnis des DSBR-Weges ist.

revised model der homologen Rekombination nach Hunter und Kleckner (2001) und Allers und Lichten (2001). Klicken für größere Version.


Auf diesem Stand möchte ich es dann auch belassen für heute. Worauf ich hier überhaupt nicht eingegangen bin, sind die vielen Proteine, die diese ganzen Wege bevölkern. Von manchen kennt man recht gut ihre Position im Schema und ihre dortige Aufgabe, von vielen anderen weiß man aber nur ungefähr, in welche Hälfte des Modells sie passen.
Im nächsten richtigen Post dieser kurzen Serie werde ich dann, bewaffnet mit dem Hintergrund zur homologen Rekombination hier, Untersuchungen unserer Mutanten zur Rekombinationsrate vorstellen.


[1] Vor der Zeit der schnellen Sequenzierung, und auch vor dem Triumphzug der PCR waren solche Marker oft Sporenfarbgene der untersuchten Pilze, oder Antibiotika-Resistenzgene.


JW Szostak, TL Orr-Weaver, RJ Rothstein, FW Stahl (1983). The double-strand-break repair model for recombination Cell, 33 (1), 25-35 DOI: 10.1016/0092-8674(83)90331-8
N Nassif, J Penney, S Pal, WR Engels, GB Gloor (1994). Efficient copying of nonhomologous sequences from ectopic sites via P-element-induced gap repair. Mol Cell Biol., 14 (3), 1613-1625
Neil Hunter, Nancy Kleckner (2001). The Single-End InvasionAn Asymmetric Intermediate at the Double-Strand Break to Double-Holliday Junction Transition of Meiotic Recombination Cell, 106 (1), 59-70 DOI: 10.1016/S0092-8674(01)00430-5
T Allers, M Lichten (2001). Intermediates of Yeast Meiotic Recombination Contain Heteroduplex DNA Molecular Cell, 8 (1), 225-231 DOI: 10.1016/S1097-2765(01)00280-5

Freitag, Februar 06, 2009

Kaffee kreiert Krebs?

ResearchBlogging.orgDie wissenschaftliche Blogwelt ist in Aufruhr: Das Schundblatt Die reich bebilderte englische "Zeitung" Daily Mail berichtet über mögliche genotoxische Gefahren von Koffein für werdende Kinder. Und zitiert dabei gleich den Wissenschaftler Marcus Cooke von der Uni Leicester, der gerade angekündigt hat, dies untersuchen zu wollen. Der Aufreger ist hier, dass einerseits eine Zeitung bereits auf Grundlage der Ankündigung eines Forschungsprojekts schwangeren Frauen ein schlechtes Gewissen einreden will, und auch noch großzügig Empfehlungen verteilt, wie man in Zukunft zu leben hat. Andererseits ist aber auch der interviewte Wissenschaftler nicht unschuldig:
‘Although there’s no evidence at all of a link between caffeine and cancer, we’re putting two and two together and saying: caffeine can induce these changes and it has been shown that these changes are elevated in leukaemia patients,’ added Dr Cooke.
Er leitet sich also aus dem Fehlen eines Beweises die Grundlage seiner Forschung und gleich auch noch das passende Ergebnis ab? Ich ruf da mal gleich beim Nobelpreiskomitee an...

Worauf die bloggenden Kollegen (mit Ausnahme von Neuroskeptic) in ihrer Aufregung aber gar nicht eingegangen sind, und Herr Cooke wohl "übersehen" hat: Die Verbindung Koffein und Genomstabilität ist bereits recht gut verstanden! Leider aber nicht so, wie es in dem Artikel dargestellt wird. Aber der Reihe nach.


Signalisierung von Schäden an der DNA

Ich bin in ein paar Posts schon auf die Reparatur von DNA-Schäden eingegangen, aber einen wichtigen Teil davon habe ich bisher unterschlagen. Denn bevor die Zelle wirklich die Schäden repariert, muss sie erst noch entscheiden, ob sich die Reparatur überhaupt lohnt. Denn bei zahlreichen Schäden besteht immer auch die Gefahr, dass sich Mutationen einschleichen. Und bevor sich dann Krebs entwickelt, opfert der Organismus lieber eine Zelle. Dieser programmierte Zelltod folgt einem strengen genetischen Programm und wird als Apoptose bezeichnet. Hat sich die Zelle entschieden, die Schäden doch zu reparieren, dann müssen zunächst die zahlreichen Reparaturproteine aktiviert werden. Außerdem sollte während der Reparatur der Zellzyklus angehalten werden. Es wäre nämlich sehr schlecht, wenn die Zelle mitten im Reparaturprozess anfängt, ihre DNA zu replizieren, oder sich zu teilen.


ATM und ATR

Eine zentrale Rolle bei all diesen Signalen spielen zwei verwandte Proteine, die beim Menschen ATM und ATR heißen. Beide sind Kinasen, also Enzyme, die die Aktivität anderer Proteine regulieren, indem sie Phosphatgruppen auf bestimmte Aminosäuren übertragen. Im Fall von ATM und ATR ist diese Kinaseaktivität nun abhängig von verschiedenen Schäden an der DNA: Dadurch werden sie aktiviert, und übertragen Phosphate auf Proteine, die die oben angesprochenen Prozesse wie Apoptose, Zellzyklus oder Reparatur regulieren. Fallen ATM und ATR aus, führt dies beim Menschen zu Erbkrankheiten wie Ataxia-telangiectasia (ATM, versucht mal das mehrmals hintereinander zu sagen) oder Seckel Syndrom (ATR). Eigentlich sollte es nicht überraschen, dass Menschen, die an Ataxia-telangiectasia leiden, sehr strahlenempfindlich sind. Ionisierende Strahlung erzeugt schließlich DNA-Schäden, und durch den Ausfall von ATM funktioniert dann die Regulation von Reparatur etc. nicht mehr. Dieser Punkt ist aber noch aus einem anderen Grund wichtig, wie wir gleich sehen werden.


Abbildung des ATM-Signalweges in der Zelle aus dem GeneAssistTM Pathway Atlas von Ambion/Applied Biosystems. Gezeigt sind die wichtigsten Prozesse, die von ATM reguliert werden. Zielprotein werden von ATM aktiviert durch Anheften von Phosphatgruppen, dargestellt durch die Kreise mit "P" an den Proteinen.


Koffein hemmt ATM und ATR


Vor ein paar Jahren machten dann ein paar Forschergruppen eine interessante Entdeckung: Die Aktivität von ATM (und ATR) kann gehemmt werden durch Gabe von Koffein. Die Gruppe von Zhou et al. hat Glück, ihr im Journal of Biological Chemistry veröffentlichter Artikel darf für Lehrzwecke auch online frei benutzt werden. Durch Arbeiten mit Zellkulturen konnten sie zeigen, dass durch die Zugabe von Koffein mehrere von ATM aktivierte Signalketten unterdrückt wurden, beispielsweise ein Stopsignal im Zellzyklus, das die Einleitung der Zellteilung bei DNA-Schäden verhindern soll (der G2/M-Checkpoint). Dieser Effekt ahmt das Verhalten von A-T Zellen (Zellen von Patienten, die an Ataxia-telangiectasia leiden und in denen ATM inaktiv ist) nach, wie in Abbildung 5 des Artikels schön zu sehen ist.


Abb. 5 aus Zhou et al. (2000)

Chk2 ist ebenfalls eine Kinase, die aber hauptsächlich den Reparaturweg reguliert und von ATM aktiviert werden muss. Ohne jetzt groß das Prinzip hinter elektrophoretischen Methoden erklären zu wollen, sieht man nach Bestrahlung der Zellen die Aktivierung von Chk2 durch ATM in der höheren Bande bei 2 (vgl. mit 1), weil das Chk2-Molekül durch Anheften einer Phosphatgrupppe größer geworden ist. Diese Aktivierung findet nach Behandlung mit Koffein nicht mehr statt (die Bande ist bei 4 auf der gleichen Höhe wie die inaktive Kontrolle bei 1, es wurde also keine Phosphatgruppe drangehängt). Dieses Ergebnis ist vergleichbar mit dem Verhalten von A-T Zellen ohne Koffeinbehandlung (Nummern 5/6).


Abb. 7 aus Zhou et al. (2000)

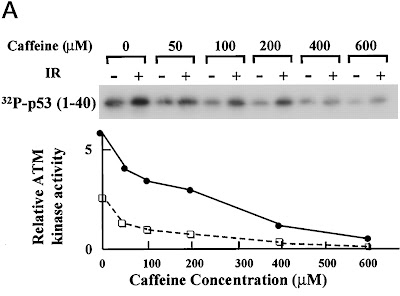
In Abbildung 7 haben Zhou und Kollegen einen weiteren von ATM regulierten Weg angesehen, die Apoptose. Sehr wichtig zum Einleiten der Apoptose (dem programmierten Zelltod) ist das Protein p53, das ebenfalls durch Anheften einer Phosphatgruppe von ATM aktiviert werden kann. Wie man hier sehr schön sehen kann, wird p53 mit steigender Koffeinkonzentration immer weniger aktiviert, und das sogar ohne Bestrahlung (ausgeüllte Kreise: +Bestrahlung, offene Quadrate: -Bestrahlung)! Dies bedeutet, dass auch in wenigen Zellen, deren DNA nicht durch Bestrahlung massiv geschädigt wurde, spontane Schäden auftreten, die in einer Aktivierung von p53 (und wohl dem Auslösen der Apoptose) resultieren. Und Koffein kann das durch Hemmung von ATM unterdrücken.


Die medizinische Anwendung

Weiter oben habe ich bei der Beschreibung der Krankheit Ataxia-telangiectasia gesagt, dass die Patienten sehr strahlensensitiv sind, und die Daten hier haben auch gezeigt warum: ATM als zentraler Regulator von vielen zellulären Prozessen nach Schädigung der DNA kann diese Prozesse nicht mehr aktivieren, die Schäden werden nicht repariert und die Zellen versuchen munter, sich trotzdem zu teilen. Da Koffein dieses Erscheinungsbild von A-T Zellen nachahmen kann, wird es seit mehreren Jahren in der Krebsmedizin eingesetzt: Tumorzellen reagieren auf eine Strahlentherapie sensitiver, wenn der Patient zusätzlich Koffein verabreicht bekommt. Und dieser nützliche Effekt konnte auch für mehrere Chemotherapeutika gezeigt werden (etwa Cisplatin).


Nicht vergessen: die Konzentration!

Was in dem Daily Mirror-Artikel leider unterschlagen wird: Um diese Effekte von Koffein beim Menschen zu erreichen, sind Konzentrationen von etwa 10 mM nötig. Nach Trinken einer Tasse starken Kaffees liegt die Konzentration im Blut aber bei etwa 50 µM [1], sie ist also circa 200 mal niedriger. Anders ausgedrückt: Koffein ist nach maximal fünf Stunden im Blut wieder abgebaut, man müsste also mindestens 200 Tassen starken Kaffee innerhalb von weniger als fünf Stunden trinken, um einen Effekt von Koffein auf ATM zu erreichen!

Das Fazit der ganzen Geschichte: Der Daily Mirror sollte sich schämen, schwangeren Frauen Angst einzujagen, und Herr Cooke sollte vor seinem nächsten Projekt zumindest fünf Minuten recherchieren, mehr brauchts nämlich nicht. Und die Literatur ist wie gezeigt zumindest teilweise frei zugänglich.


[1] Berechnet aus einer Koffein-Plasmakonzentration von 10 mg/l und der Annahme von 8 mg/kg Koffein nach Genuss einer Tasse Kaffee.
[2] Sorry für den Titel, aber ich konnte es mir nicht verkneifen ;-)


Zhou, B. B., Chaturvedi, P., Spring, K., Scott, S. P., Johanson, R. A., Mishra, R., Mattern, M. R., Winkler, J. D., Khanna, K. K. (2000). Caffeine abolishes the mammalian G(2)/M DNA damage checkpoint by inhibiting ataxia-telangiectasia-mutated kinase activity J Biol Chem, 275 (14), 10342-10348

Montag, Januar 26, 2009

Projekt Paperübersicht #2: Der RTR-Komplex in Pflanzen?

Und weiter gehts mit der Besprechung unseres aktuellen Papers! Während es in Teil 1 noch um ein wenig Hintergrund für die beteiligten Gene/Proteine ging, gehts heute ins Pflanzengenom und die Frage, ob es diesen RTR-Komplex auch in der Modellpflanze Arabidopsis thaliana gibt.


Den Großteil unserer Arbeit machen wir mit Insertionsmutanten. Das sind Pflanzen, bei denen mit Hilfe des Bodenbakteriums Agrobacterium tumefaciens relativ große DNA-Fragmente in die Sequenz eines Gens eingeführt wurden. Dies führt im Endeffekt dazu, dass das Proteinprodukt dieses Gens nicht mehr hergestellt werden kann, die Pflanzenlinie unterscheidet sich also von Wildtyppflanzen nur darin, dass ein bestimmtes Gen ausgeschaltet wurde. Der Sinn hinter der Untersuchung von diesen Knockouts ist schnell einleuchtend: Vergleicht man Wildtyp und Knockoutlinie, dann ist sehr wahrscheinlich, dass jeder zusätzliche Defekt in der Knockoutlinie auf dem Ausfall des Gens beruht. Jetzt muss man nur noch umdenken - der Ausfall eines Gens führt zu bestimmtem Defekt, dann erfüllt dieses Gen normalerweise diese bestimmte Funktion, die ein Entstehen des Defekts verhindert.

Zunächst muss man sich natürlich fragen: Gibt es die Gene des RTR-Komplexes überhaupt in Arabidopsis? Hier kann man sich heutzutage sehr viel Arbeit sparen, dank sehr guter Bioinformatik und den frei zugänglichen Genomdatenbanken vieler Organismen. Was wir fanden, passt sehr gut den bereits beschriebenen Genen, vor allem aus der Bäckerhefe Saccharomyces cerevisiae und dem Menschen.
Für das Gen RMI1 (bzw. BLAP75) gibt es im Arabidopsisgenom zwei mögliche Kandidaten. Einer davon (das Gen At5g19950) scheint nicht exprimiert zu werden, und auch von uns untersuchte Insertionsmutanten waren völlig unauffällig. Hierbei könnte es sich also um ein Pseudogen handeln. Der zweite Kandidat (At5g63540) war dafür umso interessanter, wie ich heute und in den folgenden Posts zu unserem Paper zeigen will. Dieses Gen wurde von uns darum AtRMI1 getauft [1].
Auf zum T aus RTR - der Topoisomerase. Hier war es leichter, weil als Homolog zu TOP3 bzw. TOPO3α nur ein mögliches Gen in Frage kam, At5g63920 oder AtTOP3α.
Ein wenig komplizierter wird es bei der RecQ Helikase. Bei dieser Familie wissen wir schon länger, dass es in Arabidopsis sieben Mitglieder gibt. Welche von diesen sieben ist nun aber das funktionelle Homolog zu der einzigen RecQ Helikase in Hefe, SGS1? Im Menschen ist dies unter fünf Familienmitgliedern das Gen BLM, und mit dem Aufbau dieser beiden Gene bewaffnet fallen schon ein paar der Arabdopsis RecQ Helikasen raus. Von den restlichen bleibt dann nur noch RECQ4A (At1g10930) übrig, wenn man bereits bekannte Eigenschaften der Mitglieder der RecQ Familie in Arabidopsis mit einbezieht (Hartung et al., 2007).

Glücklicherweise waren für diese Gene dann auch Insertionsmutanten verfügbar, mit denen wir arbeiten konnten.

Zum Abschluss jetzt noch ein paar "richtige" Daten. Die Beschreibung, wie und warum man bestimmte Gene überhaupt gefunden und benutzt hat, und wie die Mutanten aufgebaut sind, ist zwar ein wichtiger Teil eines Papers - es ist aber eher langweilig.
Es gibt eine relativ einfache Methode, die Beteiligung eines Gens bzw. dessen Proteinprodukts an der DNA Reparatur zu untersuchen: Schädigt man die DNA absichtlich, dann müssen diese Schäden repariert werden. Ist nun aber ein Gen ausgeschaltet, das in die Reparatur der DNA involviert ist, dann funktioniert die Reparatur logischerweise nicht mehr so gut. Das kann man auf verschiedene Weisen messen, wir bestimmen das relative Frischgewicht von behandelten Keimlingen verglichen mit gleich alten unbehandelten Keimlingen. Denn Probleme bei der DNA-Reparatur resultieren beispielsweise im Absterben der betroffenen Zellen, die sich dann auch nicht mehr Teilen oder Wachsen können. Die Folge: Kleinere, leichtere Keimlinge.
Die Bandbreite an möglichen Schäden an der DNA ist unheimlich groß, entsprechend gibt es auch jede Menge von Reparaturwegen. Indem man die Organismen verschiedenen Stoffen mit bekannten Schadeffekten an der DNA aussetzt, kann man mit diesem Versuch auch eine erste Einordnung der untersuchten Gene in diese Reparaturwege vornehmen. Eine Knockoutmutante wird nämlich nur dann sensitiver als der Wildtyp auf einen Stoff reagieren, wenn es in dem betroffenen Reparaturweg aktiv ist.


Abbildung 3 aus Hartung et al (2008)

In dieser Abbildung sind Sensitivitäten von Knockoutmutanten der Gene RECQ4A, TOP3α und RMI1 gegenüber verschiedenen Mutagenen gezeigt. Gegen Methylmethansulfonat (MMS, A in der Abbildung) sind viele Gene der homologen Rekombination sensitiv, so auch unsere drei Gene. MMS erzeugt Addukte an der DNA, indem es eine Methylgruppe an Stickstoffatome in den Basen der DNA hängt. Dies hat zu Folge, dass die normale Doppelhelix verzerrt wird, und elementare Vorgänge wie die Transkription und Replikation nicht mehr stattfinden können. Dies ist wahrscheinlich auch die Verbindung mit der homologen Rekombination, da sie mithilft Probleme direkt an der Replikationsgabel zu beheben. Davon abgesehen können Schäden durch eine Alkylierung aber auch durch die Reparaturwege der Basenexzisionsreparatur und der Nukleotidexzisionsreparatur behoben werden [2]. Die Ungenauigkeit dieser beiden Wege führt übrigens über den Umweg von Mutationen zu einer krebsfördernden Wirkung von MMS.
Cisplatin (genauer cis-Diamindichlorplatin, B in der Abbildung) ist ein interessanter Stoff. Über die eher zufällige Entdeckung dieses kleinen Moleküls habe ich schon mal geschrieben. Heute ist es einerseits eines der am häufigsten eingesetzten Chemotherapeutika, andererseits aber auch eines der bestuntersuchten Stoffe, was die Mechanismen der DNA-Schädigung angeht. Was passiert, wenn Cisplatin in die Zelle kommt? Das zentrale Platinatom reagiert freudig mit so ziemlich jedem Molekül, das es in die Finger kriegt. Deshalb findet man dann Platinaddukte an Zuckern, Fetten, Proteinen, aber eben auch der DNA. Blöd an der Sache ist aber, dass Cisplatin über seine beiden Chloridgruppen auch zweimal reagieren kann, und damit zwei vorher unverbundene Moleküle kovalent verknüpft. So werden dann schon mal Proteine an die DNA gebunden, oder noch schlimmer, zwei Basen der DNA kovalent verbunden. Dies nennt man Crosslinking, und davon gibt es zwei Möglichkeiten: entweder werden zwei Basen aus unterschiedlichen DNA-Strängen verknüpft (=Interstrang-Crosslink), oder es werden zwei Basen innerhalb eines Stranges verknüpft (=Intrastrang-Crosslink). Letzteres ist bei Cisplatin das häufigere Produkt, und auch hier liegen die Reparaturaufgaben bei der Nukleotidexzisionsreparatur und der homologen Rekombination (die besonders während der Replikation).
Zuletzt noch Camptothecin (CPT, C in der Abbildung). Das ist ein Alkaloid, das beispielsweise von der Pflanze Camptotheca acuminata zur Schädlingsabwehr gebildet wird. Und die Schädlinge, die an der Pflanze knabbern tun mir wirklich leid: Im vorigen Teil habe ich knapp beschrieben, was eine Topoisomerase mit der DNA macht. Camptothecin behindert diesen Vorgang der Topoisomerase 1. Genau in dem Zustand, wenn TOP1 kovalent mit der DNA verbunden ist und ein Einzelstrangbruch in der DNA vorliegt, bindet CPT daran und verhindert, dass die Topoisomerase die Lücke schließt und sich von der DNA löst. Dies hat zur Folge, dass bei der Replikation einerseits ein Protein kovalent verbunden auf der DNA sitzt und die Replikationsproteine behindert, und dass außerdem durch das Entwinden des Doppelstrangs aus dieser Lücke in der DNA plötzlich ein Doppelstrangbruch wird. Großes Problem, und sehr wahrscheinlich der Tod des hungrigen Schädlings [3].

Wie man sehen kann, sind alle Mutanten sensitiver als der Wildtyp (Col-0 in der Abbildung) gegenüber MMS und Cisplatin. Gegen CPT ist dagegen nur die Knockoutmutante von TOP3α sensitiv, die beiden anderen nicht. top3A-2 reagiert genau genommen auch auf MMS und Cisplatin sensitiver als recq4A-4 und rmi1-2. Während nun diese gemeinsamen Sensitivitäten eines der Indizien sind, dass die drei Proteine ihre Aufgaben gemeinsam erfüllen (also möglicherweise in einem RTR-Komplex), deuten die Resultate auch auf eine Sonderrolle für TOP3α hin. Auf die will ich aber erst im nächsten oder übernächsten Post eingehen - mit nem Cliffhanger müsst ihr einfach wiederkommen, oder?


[1] So wirklich neue und kreative Namen gibts bei Genen eher selten, aber es kommt vor. Siehe etwa das Gen SUPERMAN und sein Antagonist KRYPTONITE...
[2] Wenn ich jetzt noch anfange, jeden Reparaturweg ausführlich zu beschreiben werde ich gar nicht mehr fertig mit dem Post. Ich hab da aber eine nette Idee: Ich könnte den Mutagenen eigene Posts widmen, und dabei dann auch auf die relevanten Reparaturwege eingehen.
[3] Die Camptothecin-produzierenden Pflanzen besitzen übrigens TOP1-Gene mit leicht veränderten Sequenzen, so dass sie selbst nicht anfällig gegenüber CPT sind (Sirikantaramas et al, 2008).

Montag, Januar 12, 2009

Projekt Paperübersicht #1: Der RTR-Komplex

Leider gab es nicht so viele Rückmeldungen auf meine Frage, ob ich über ein aktuelles Paper, bei dem ich Mitautor bin, hier berichten soll. Die Umfrage in der Sidebar wurde genau 1 Mal angeklickt. Da das Ergebnis nun aber bei 100% für das Erklären steht, werde ich das auch tun. Nur werde ich, wie caesar im Kommentarteil geschrieben hat, auf ein Einstellen bei researchblogging verzichten. Deren Richtlinien verbieten zwar nicht das Schreiben über eigene Paper, mir scheint das aber trotzdem nicht vertretbar zu sein.
Da in dem Paper mehrere Punkte zur Sprache kommen, die auch auf eigenen Beinen stehen können, werde ich die Besprechung des Papers aufteilen. So wird das nicht ein Megapost, und ich kann jeweils besser auf den Hintergrund eingehen.

Heute beginne ich damit, die für das Paper relevanten Gene und ihre Proteinprodukte kurz vorzustellen, dass jeder eine Vorstellung über ihre Funktion in der Zelle hat. Zentral steht hier ein Komplex aus drei Proteinen, die für sich alleine gänzlich unterschiedliche biochemische Eigenschaften haben.

Über die Familie der RecQ Helikasen habe ich bisher nur sehr wenig geschrieben, obwohl ich mich schon seit meiner Diplomarbeit mit ihnen beschäftige. Aus dem Biounterricht kennen manche vielleicht noch den Begriff der Helikase für ein Protein, das für das Kopieren der DNA (die Replikation) benötigt wird. Da in der DNA zwei Stränge aneinandergelagert sind, kann sie erst dann kopiert werden, wenn die Basenpaarungen aufgelöst wurden. Dies wird durch eine Gruppe von Proteinen namens Helikasen erreicht, die unter Energieverbrauch aus einem Doppelstrang zwei Einzelstränge machen. Danach kann dann das lustige DNA-Kopieren starten. Helikasen werden jedoch nicht nur während der Replikation gebraucht - die meisten Vorgänge an der DNA benötigen die Hilfe einer Helikase, warum es von denen im menschlichen Genom auch laut der Proteindatenbank UniProt über 150 gibt. Beschäftigt man sich ein wenig intensiver mit dem Metabolismus der DNA, dann läuft man fast zwangsläufig einer Familie von Helikasen (also eine Gruppe von Proteinen, deren Gene evolutionär verwandt sind und alle ein einziges Gen als gemeinsamen Vorfahren haben), den RecQ Helikasen. Das liegt daran, dass Vertreter dieser Familie verschiedenste Aufgaben im Erhalt der DNA, so wie wir sie kennen, besitzen: Sie sind aktiv in der Rekombination und der Reparatur von DNA, man findet sie an den Enden der Chromosomen, der Telomere, wo sie für den Erhalt dieser Strukturen beitragen und somit beispielsweise ein schnelles Altern unserer Zellen verhindern. Andere Familienmitglieder nehmen Funktionen im Gene Silencing wahr (das auch als RNAi bekannte Phänomen wurde 2006 mit dem Nobelpreis belohnt). Biochemisch erfüllen RecQ Helikasen diese Funktionen in der Regel, indem sie besondere DNA-Strukturen [1] erkennen, und sie unter Energieverbrauch wieder auflösen. Fallen diese Funktionen in tierischen Zellen aus, dann kann Krebs entstehen.
Die allermeisten einzelligen Lebewesen besitzen genau eine RecQ Helikase, die als Allroundtalent die meisten dieser Aufgaben erfüllt. Interessanter, aber auch komplizierter, wird es in vielzelligen Lebewesen, da diese mehrere Gene für RecQ Helikasen in ihren Genomen tragen, die die Aufgaben untereinander aufgeteilt haben. Menschen haben beispielsweise 5, Arabidopsis sogar 7 RecQ Gene. Ein recht gut untersuchtes Familienmitglied beim Menschen heißt BLM, weil es durch Mutation die verheerende Erbkrankheit Bloom Syndrom auslösen kann. Funktionell entspricht dies in Arabidopsis dem Gen RECQ4A. Beide unterdrücken die Rekombination und sind involviert in bestimmte Arten von DNA-Reparatur. Zumindest ein Teil dieser Aufgaben wird in dem RTR-Komplex wahrgenommen, um den es heute geht. Darum will ich es auch gut sein lassen für jetzt.

Das zweite Protein im Komplex ist eine Topoisomerase. Sie wird in der Bäckerhefe TOP3, in vielzelligen Eukaryoten TOPO3α genannt. Topoisomerasen lösen topologische Probleme der DNA - darum der Name. Ein einfaches Beispiel soll helfen zu verstehen, was damit gemeint sein soll: Stellt euch ein Gummiband vor; ein Ende macht ihr an einem Türgriff fest, das andere haltet ihr in der Hand. Nun verdrillt (überdreht) ihr das Gummiband. Wie lässt sich diese Überdrehung wieder auflösen, wenn die Enden fest verankert sind? Mit der DNA ist das etwas einfacher als mit einem Gummiband, aber genau das machen Topoisomerasen: Sie schneiden einen Strang durch, an dieser Position kann das Gummiband/die DNA nun frei drehen. Wenn die Überdrehung aufgelöst wurde (dies geschieht durch die in der Überdrehung gespeicherten Energie von selbst), schließt die Topoisomerase die Lücke wieder. Ein geschnittenes und geklebtes Gummiband würde man wohl nicht mehr benutzen, aber in der DNA bedeutet dies nur das Lösen und Verknüpfen einer Bindung im Molekül, das macht also keinen Unterschied [2].

Der dritte Komplexpartner heißt in der Bäckerhefe RMI1 und im Menschen BLAP75. Anders als die ersten beiden Proteine scheint es keine enzymatische Funktion zu besitzen. Trotzdem erfüllt der Komplex seine Aufgabe schlechter, wenn man dieses Protein daraus entfernt. Dies liegt wahrscheinlich daran, dass RMI1/BLAP75 einerseits die Erkennung von und Bindung an besondere DNA-Strukturen fördert, und andererseits Helikase und Topoisomerase im Komplex zusammenhält. Auf diese Weise können die beiden Proteine ihre Aufgaben kooperativ erfüllen.
Vor kurzem konnte gezeigt werden, dass der Komplex auch ein Protein namens RMI2/BLAP18 enthält. Dieses ist nahe verwandt mit RMI1, und beide ergänzen sich in ihrer Funktion. Außerdem ist schon bekannt, dass noch weitere, bisher unidentifizierte Proteine im Komplex enthalten sind.

Aufgrund der drei zentralen Proteine erhielt der Komplex jedoch seinen Namen - BTB für BLM, TOPO3α und BLAP75 im Menschen beziehungsweise RTR für RecQ Helikase, TOP3 und RMI1 in der Bäckerhefe. Was er genau mit der DNA anstellt, darauf will ich in einem gesonderten Post eingehen. Kurz erwähnen will ich nur noch, dass der RTR-Komplex vor kurzem die traurige Ehre zuteil wurde, von Kreationisten als "Argument" missbraucht zu werden.


[1] Wer sich schon gefragt hat, wo der nächste Post in der Serie DNA-Strukturen bleibt - schuldig im Sinne der Anklage. Es ist ja nicht so, dass mir da die Themen ausgingen. Es geht bald wieder weiter damit, versprochen!
[2] Es gibt noch eine zweite Form von Topoisomerasen. Die schneiden nicht einen, sondern beide Stränge der DNA durch. Das ist etwa dann nötig, wenn mehrere Chromosomen ineinander verknotet sind.

Mittwoch, Dezember 24, 2008

Weihnachtspaper!

Die Firma DNA 2.0 hat nach dem Weihnachtspaper von 2006 (Santa Claes, Rudolph Reindeer, Saint Nicolas, Ness E. Tomte, Dasher Sridhar, Jeremy Elf (2006): Heterologous expression and functional characterization of the Santa Hoho2 gene. Proc Natl Acad Sci, North Pole 12:25-31. [PDF]) dieses Jahr endlich ein neues weihnachtlich angehauchtes Paper veröffentlicht!

Santa Claes, Feliz Navidad, Tomte Ness E., Ten N. Baum, Hanukkah Harry, Bada Din Sridhar, Jeremy Elf (2008): Metabolic engineering of Picea abies for receptor mediated induction of fluorescence and olfactory signaling. Proc Natl Acad Sci, North Pole 12:25-31. [PDF]

Abstract
Reoccurring seasonal harvesting of Picea abies (Norwegian spruce) and the subsequent attachment of light fixtures to the tree followed by composting after only 3 weeks of minimal use is not only a waste but also leads to diminishing spruce forests, release of carbon dioxide, global warming, increased energy consumption and a political burden to the ongoing diplomatic efforts of Santa Claus. We here present a synthetic biology solution to address this key concerns for winter celebrations – A song induced Christmas tree with endogenous light and odor emission. Advances in synthetic biology, tissue engineering and metabolic engineering have now provided new insights and techniques for controlling whole organism signaling and bio-compound production in situ, and recent efforts in synthetic biology have demonstrated that complex regulatory and metabolic networks can be designed and engineered in microorganisms and simple eukaryotes. Leading researchers at the NorthPole Bioscience Engineering Council here disclose how sonic-induced signals received through tissue engineered tympanal organs are incorporated into regulating the metabolic distribution of fluorescent and olfactory signals in Picea abies. Upon induction, the cellular nodality of the tree branches emit light at predefined wavelength due to engineered luciferases mTwinkie (yellow), mWonderbread (white) and mSnoBalls (pink). The synthetic induction system also triggers the production and emission of seasonal olfactory signals including trans-cinnamaldehyde (cinnamon), 6-gingerol (ginger), and methyl salicylate (mint). The synthetic pathway is hereby denoted xmas1.
In diesem Sinne - ich wünsche euch allen Frohe Weihnachten! Und versucht mal, euren Baum anzusingen, vielleicht habt ihr ja eins dieser transgenen Exemplare bei euch stehen!

Ein nettes vorgezogenes Weihnachtsgeschenk

Nach Monaten von Warten kam letzten Freitag endlich das neueste Paper unseres Instituts raus - und ich bin einer der Mitautoren (Wenn auch nicht der Erstautor, was ich auf jeden Fall betonen will.)! Das ist zwar nicht mein erstes Paper [1], aber an dieser Arbeit war ich während meiner Diplomarbeit beteiligt und bin es auch aktuell während meiner Doktorarbeit.
Da der Artikel bei PLoS Genetics erschienen ist, kann ihn jeder kostenlos lesen, also super für Open Access! Spannend an der Geschichte ist auch, dass wir den Artikel back-to-back mit einem zweiten Paper der Gruppe von Mathilde Grelon aus Versailles veröffentlicht haben. Deren Ergebnisse ergänzen sich sehr gut mit unseren, so dass PLoS Genetics sogar noch nen Perspective-Artikel dazu hat schreiben lassen.
Ich bin jetzt gerade ein wenig unentschlossen, wie ich hier weitermachen soll. Einerseits halte ich das Thema für sehr interessant und spannend (natürlich!), andererseits kommt es mir aber extrem merkwürdig vor, über eigene Arbeiten zu schreiben. Wäre das nicht ein wenig wie Werbung? Haltet ihr mich für objektiv genug, oder sieht das dann so aus, als wollte ich unsere Daten in ein positiveres Licht rücken? Ich werd also eine kleine Umfrage in die Seitenleiste stellen, dann dürft ihr das entscheiden!

Hartung F, Suer S, Knoll A, Wurz-Wildersinn R, Puchta H (2008): Topoisomerase 3α and RMI1 Suppress Somatic Crossovers and Are Essential for Resolution of Meiotic Recombination Intermediates in Arabidopsis thaliana. PLoS Genet 4(12): e1000285.


[1] Darüber hatte ich vergessen zu berichten, das erste Paper bei dem ich Mitautor bin kam im Oktober raus. Mein Anteil an der Veröffentlichung geht noch auf ein längeres Praktikum während des Studiums zurück, am Institut für Rebenzüchung in Siebeldingen in der Südpfalz, einer Einrichtung des Julius-Kühn-Instituts (Bundesforschungsinstitut für Kulturpflanzen).

Kortekamp A, Welter L, Vogt S, Knoll A, Schwander F, Töpfer R, Zyprian E (2008): Identification, isolation and characterization of a CC-NBS-LRR candidate disease resistance gene family in grapevine. Molecular Breeding 22(3):421-432.

Sonntag, Oktober 12, 2008

Die Nobelpreise 2008 für Life Sciences

Mit dem Preis für Physiologie oder Medizin am Montag und dem für Chemie am Mittwoch sind die möglichen Kategorien für Biologen in der diesjährigen Nobelpreisrunde durch. Die Preisträger für Medizin hatte dieses Jahr niemand auf seiner Liste möglicher Kandidaten. Ausgezeichnet für ihre Leistungen wurden die beiden Franzosen Françoise Barré-Sinoussi und Luc Montagnier für die Entdeckung des HI-Virus und der Deutsche Harald zur Hausen für die Verbindungen von Infektionen mit Papillomaviren und der Entstehung von Gebärmutterhalskrebs.

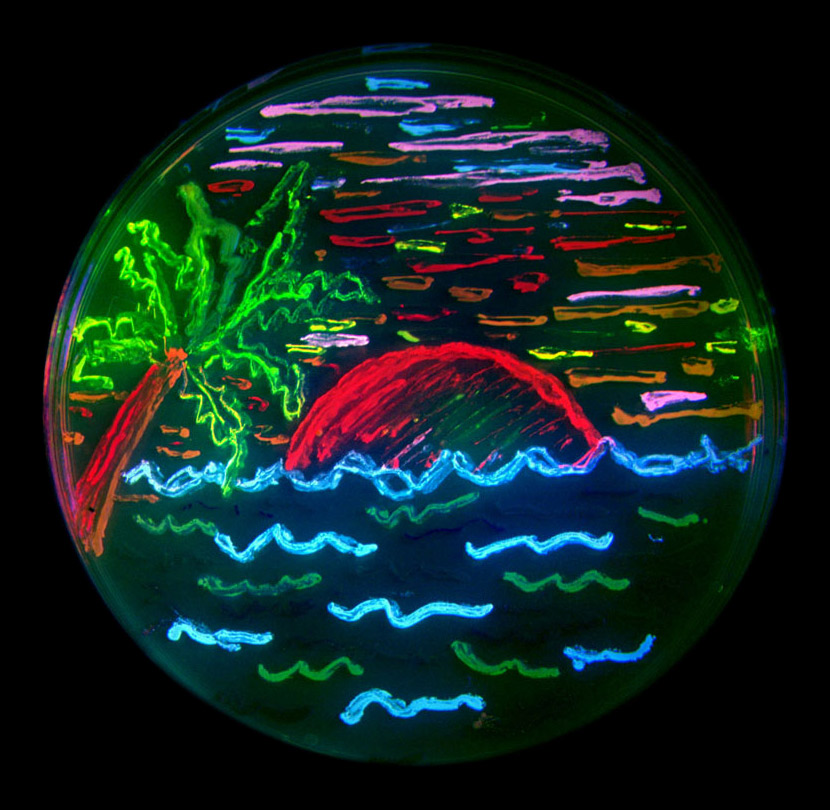
Bakterien, die die aktuell vorhandenen Farbvarianten von fluoreszenten Proteinen exprimieren.

Am Mittwoch wurde dann die Entwicklung einer mittlerweile zentralen Methode der biologischen Grundlagenforschung mit dem Chemie-Nobelpreis belohnt: fluoreszente Proteine. Bereits in den 1960ern und 70ern isolierte Osamu Shimomura das grünfluoreszierende Protein GFP aus der Qualle Aequorea victoria. Dann geschah lange Zeit nichts, bis Douglas Prasher (der hier leer ausging) Anfang der 1990er mit der Klonierung des GFP-Gens begann, die Martin Chalfie schließlich beendete. Er konnte das Gen in das Bakterium Escherichia coli und den Fadenwurm Caenorhabditis elegans einbringen und zeigte, dass die Zellen dieser Organismen, die GFP produzierten, grün fluoreszierten. Damit war der Grundstein gelegt für einen Siegeszug von GFP in fast jedem Gebiet der Life Sciences. Roger Y. Tsien vergrößerte das Potential um ein Vielfaches - ausgehend vom herkömmlichen GFP erzeugte er eine ganze Reihe von Farbvarianten durch künstliche Evolution im Labor. Die Anwendungsmöglichkeiten für fluoreszente Proteine sind fast unendlich, eine Auswahl der grundlegenden findet sich bei WeiterGen [1], dem Fischblog und Pharyngula und zahlreichen weiteren Blogs.
Ich möchte deshalb hier einige der abgeleiteten Methoden vorstellen, die aber alle auf den Grundeigenschaften von fluoreszenten Proteinen basieren.

FRET (Fluorescence Resonance Energy Transfer)
Um ein fluoreszentes Protein (FP) sichtbar zu machen, muss man es mit Licht einer bestimmten Wellenlänge bestrahlen (das Anregungslicht). Das FP emittiert darauf ein Licht einer größeren (energieärmeren) Wellenlänge. Im Beispiel von GFP sind das 488 bzw. 509 nm. Bei FRET nutzt man nun das Wissen um Anregungs- und Emissionwellenlängen, um die Interaktion von Proteinen zu untersuchen. Will ich wissen, ob Protein A und Protein B miteinander interagieren, dann kann ich je ein FP mit einem der Zielproteine verknüpfen. Nur bei der Interaktion beider Proteine kommen die beiden FPs in eine räumliche Nähe zueinander. Das hat aber auf die Fluoreszenz einen nützlichen Effekt: Rege ich das erste FP mit seinem eigenen Anregungslicht an, dann erhalte ich nicht wie übliche dessen Emissionslicht zurück, sondern das des zweiten FPs, das ich überhaupt nicht angeregt habe! Wie geht das? Aufgrund der großen räumlichen Nähe der beiden FPs kann das erste FP seine Energie nach der Anregung auf das zweite FP übertragen, anstatt selbst Licht zu emittieren. Das heißt also: nur wenn die beiden Proteine A und B miteinander interagieren, kommt es zu FRET zwischen den beiden damit verknüpften FPs. Durch FRET kann man untersuchen, ob, wo und wann Proteine in der lebenden Zelle interagieren. Clever!

BiFC (Bimolecular Fluorescence Complementation)
FRET ist eine tolle Methode, um Proteininteraktionen zu untersuchen. Leider benötigt man dafür spezielle Geräte (Mikroskop, Laser, Detektion), man kann ein FRET-Experiment nicht mit einem normalen Fluoreszenzmikroskop durchführen. Das ist mit der etwas neueren Methode BiFC (oft auch split-YFP genannt, weil der Versuch klassischerweise mit dem Yellow Fluorescenz Protein YFP durchgeführt wird) aber gut möglich. Grundlage dieser Methode ist eine tolle Eigenschaft der fluoreszenten Proteine: man kann das Gen für ein FP in zwei Hälften teilen, die beiden Proteinhälften bilden in der Zelle dann ein funktionsfähiges, fluoreszierendes Protein! Praktisch an der Sache ist aber, dass sie das für sich alleine nicht machen, sondern nur wenn die FP-Hälften künstlich in enge räumliche Nähe in der Zelle gebracht werden. Zum Beispiel, indem man je eine Hälfte an eins von zwei Zielproteinen hängt, deren Interaktion man untersuchen möchte. So kommen die FP-Hälften nur zusammen, wenn die Zielproteine interagieren - man sieht die Fluoreszenz also nur dann und dort in der Zelle, wann und wo die Interaktion stattfindet. [2]

FRAP (Fluorescence Recovery After Photobleaching)
In der Zelle herrscht jede Menge Dynamik. Proteine werden in bestimmte Organelle transportiert, werden zu bestimmten Zeitpunkten oder äußeren Zuständen aktiv oder inaktiv, etc. Mit Hilfe von FPs hat man die Möglichkeit, die Wanderung von Proteinen in der Zelle zu beobachten. Ursprünglich fluoresziert jeder Bereich in der Zelle, in dem sich das mit dem FP verknüpfte Zielprotein befindet. Wenn ich nun wissen möchte, ob das Zielprotein in einen kleinen Bereich in der Zelle transportiert wird (und wie schnell das geht, wie es reguliert wird, wann es geschieht), kann ich eine normalerweise problematische Eigenschaft von FPs für meinen Vorteil nutzen. Die große Energiemenge, mit der FPs bombardiert werden, führt irgendwann zu ihrem Ausbleichen. Das heißt, dass sie letztlich zerstört werden. In normalen Experimenten stört dies natürlich ungemein, weil man nicht unbegrenzt Beobachtungen machen kann. Für diese eine Anwendung hilft das Ausbleichen aber: Mit sehr starkem Anregungslicht kann der Zielbereich in der Zelle künstlich ausgebleicht werden. Wird das Zielprotein in der Zelle dorthin transportiert, dann sollte die Fluoreszenz aber mit der Zeit wieder zunehmen. Jetzt kann man die Zeit bestimmen, bis die Fluoreszenz wieder den Ausgangswert erreicht hat, und dadurch auf die Transportrate schließen. Viele Proteine werden durch spezielle Transportproteine durch die Zelle befördert. Dies kann man testen, indem man ein FRAP-Experiment durchführt und dabei einzelne Transportproteine ausschaltet. Ist ein solches am Transport des Zielproteins beteiligt, dann sollte die Fluoreszenz nach dem Ausbleichen nicht mehr zurückkehren.

Brainbow
Diese Methode wurde von Jeff W. Lichtman und Joshua R. Sanes von Harvard entwickelt, um einzelne Nervenzellen individuell anzufärben. Im Grunde kombinierten sie die vorhandenen Farben der fluoreszenten Proteine miteinander, um so über 100 verschiedene Farben erzeugen. Dies ist möglich über ein spezielles genetisches System, das zufällig nur wenige FP-Gene in einer Zelle aktiviert. So sollten, bei einer so großen Bandbreite von möglichen Farben, benachbarte Zellen unterschiedlich gefärbt sein. Und genauso ist es auch, wie Bilder wie dieses hier zeigen.


Das ist nur eine kleine Auswahl von Methoden, die alle darauf beruhen, dass die Preisträger des dieshährigen Nobelpreises für Chemie das Potential von fluoreszenten Proteinen für die wissenschaftliche Gemeinschaft entwickelten. Weitere abgeleitete Methoden findet man in dieser Liste auf der Wikipedia.

Eine kurze Geschichte möchte ich noch erwähnen, die nach der Verkündung der Nobelpreisträger für Chemie am Mittwoch zutage kam. Douglas Prasher, der den Preis nicht erhielt, begann wie ich oben geschrieben habe mit der Klonierung von GFP. Nach ersten Erfolgen musste er aber das Projekt einstellen, weil seine Fördermittel eingestellt wurden [3]. Wie ich auf The Daily Transcript erfahren habe, führte NPR (das National Public Radio der USA) ein Interview mit Prasher über seinen Teil an der GFP-Forschung durch. Er versteht, warum er den Preis nicht erhalten hat, und gönnt ihn den Preisträgern, die durch Prashers Vorarbeit erst zu ihren Ergebnissen kamen.
One of the winners, Roger Tsien of the University of California, San Diego, says he was lucky. At just the right time, a researcher named Douglas Prasher at the Woods Hole Oceanographic Institution in Massachusetts isolated the gene that Tsien wanted.

"So I found his phone number, called him up, and to my amazement he was willing to give out the gene," Tsien says.

Another of the Nobel laureates, Martin Chalfie of New York's Columbia University, also got the gene from Prasher.

Sehr traurig ist aber, dass Prasher nun überhaupt nicht mehr forscht, sondern Busfahrer ist, um seine Familie zu ernähren.
"I got a hard luck story," he says.
[...]
"At that time, I knew I was going to get out of it; my funding had already run out," Prasher says.

He went to work for a laboratory run by the U.S. Department of Agriculture, then took a job with a NASA contractor in Huntsville. But two-and-a-half years ago, NASA cut his project and Prasher lost his job.

He tried to find a job in science but failed. So he went to work at the car dealership.
[...]
But the job does not pay enough to support his family.

"Our savings is gone; just totally gone," he says.

Prasher is still looking for a research job, but he worries that after two-and-a-half years, his knowledge and skills may be out of date.

That's not what some of his former colleagues say. One called Prasher's current situation a "staggering waste of talent."


[1] Tobias von WeiterGen hatte übrigens vor der Vergabe der Nobelpreise einen kleinen Wettbewerb gestartet, in dem man die Gewinner für Medizin und Chemie tippen konnte. Ich lag zwar bei Medizin total daneben, aber den Chemie-Nobelpreis für GFP habe ich richtig getippt und habe dafür ein WeiterGen-Shirt gewonnen! Dass ich ein Bild von dem Tshirt poste, sobald es bei mir ankommt ist ja klar!
[2] Vor kurzem wurde eine Verbindung von FRET und BiFC beschrieben, um Interaktionen von trimeren Proteinkomplexen zu untersuchen. Durch splitten des Akzeptor-FPs eines klassischen FRET-Experiments in zwei BiFC-Hälften klappt der Resonanzenergietransfer nur, wenn zuerst die beiden FP-Hälften zu einem funktionellen FP zusammengebaut werden, und anschließend das Donor-FP in räumliche Nähe kommt.
[3] Was mal wieder zeigt, wie kurzsichtig die finanziellen Trägereinrichtungen sein können.

Samstag, Oktober 04, 2008

EndNote verklagt Zotero

Als ich vor kurzem über das Paperverwaltungstool Mendeley berichtete, habe ich auch die Alternative Zotero erwähnt. Das ist eine Firefox-Erweiterung, die nicht nur eine Literaturdatenbank beinhaltet, sondern auch vieles im Onlinebereich unterstützt, etwa die automatische Übernahme von Literaturdaten aus Webseiten. Was ich an Mendeley noch bemängelt habe, nämlich die fehlende Einbindung in Word und co., hat Zotero schon. Doch das ist Dr. Daniel J. Cohen und seinem Arbeitgeber, der George Mason University, schlecht bekommen. Literaturzitate in Texten müssen nach verschiedenen Stilen aufgebaut sein (welche Reihenfolge für Autoren, Jahr und Titel, was wird fett, was kursiv?...), und leider hat jeder Journal seinen eigenen Stil. Da ist es natürlich toll, wenn man sich einfach die fertigen Stilvorgaben des Journals, für den man einen Artikel schreibt, runterladen und dem Literaturprogramm geben kann. Für EndNote wurde damals ein Dateiformat entwickelt, das genau das macht.
Als Hilfe für die Zotero-Nutzer wurde dann ein Tool gebastelt, das die EndNote-Stildateien (.ens) in Zotero-Stildateien (.csl) umwandeln kann. Und das passt dem EndNote-Hersteller Thomson-Reuters (ja, das Reuters!) überhaupt nicht, denn der hat Zotero Entwickler auf über 10 Millionen Dollar verklagt:
The complaint states, “Dr. Daniel J. Cohen, Associate Professor, Department of History and Art History, and the director of GMU’s Center for History and New Media, developed Zotero, which is a freely distributable, open-source software based research tool that allows users to gather, organize and analyze sources, including citations, and freely share the results with others.” The Center for History and New Media release “a new beta version of Zotero to the general public” on July 8. Reuters adds, “A significant and highly touted feature of the new beta version of Zotero, however, is its ability to convert – in direct violation of the License Agreement – Thomson’s 3,500 plus proprietary .ens style files within the EndNote Software into free, open source, easily distributable Zotero .csl files.”
Ich bin kein Jurist, deshalb habe ich keine Ahnung welche Chancen diese Klage in den USA haben wird. Aber ich kann trotzdem mal ein wenig über Sinn und Unsinn derselben nachdenken.
Zunächst einmal ist nur das Dateiformat .ens von EndNote geschützt, und vielleicht noch ein paar der Stile die vom Hersteller erstellt wurden. Die allermeisten Stildateien wurden aber entweder von Journals erstellt, dass die Autoren sie sich herunterladen können, oder von vielen Nutzern [1]. Dass es EndNote also wohl seinen Kunden über das License Agreement verbietet, selbsterstellte Stildateien außerhalb von EndNote zu benutzen ist eine Frechheit.
Dann kommt mir diese Taktik irgendwie bekannt vor: Ein großer Konzern, der sein Marktsegment beherrscht, verklagt seine eigenen Kunden. Woher kenn ich das wieder? Achja, die Musikindustrie! Und wie gut das läuft, ist ja allgemein bekannt. Wieso verärgert jemand den eigenen Kundenstamm? Ich verstehe es auch nach Jahren nicht, das kann doch nicht gut für das Produkt sein.
Zusammengefasst hört sich das nämlich für mich so an: "Nachdem wir jahrelang unser etwas veraltetes Produkt konkurrenzfrei anbieten konnten, kommt jetzt so ein Kerl an und gibt seine Alternative kostenlos her. Und das noch mit mehr Features! Den klagen wir in Grund und Boden!"

Damit ist für mich die Entscheidung gefallen: Eine solche Firma möchte ich nicht unterstützen. Mit einem der nächsten Updates werde ich endgültig zu Mendeley wechseln. Ich werde auch den Kollegen raten, lieber freie Alternativen zu nutzen, wenn sie überlegen eine neue EndNote-Version zu kaufen. Und euch rate ich das gleiche. Werft einen Blick auf Zotero, Mendeley und Papers (für Macs), die werden eure Daten nicht in proprietären Zellen einsperren!
[via Crooked Timber]

[1] Wir haben beispielsweise eine Stildatei am Institut, die den Vorgaben für eine Diplomarbeit entspricht. Und die ist sicher nicht von EndNote.

Montag, September 22, 2008

Pilz-Videos

Ein nettes Video mit Zeitrafferaufnahmen von Pilzen und Schleimpilzen hab ich auf boingboing entdeckt:
Adblock


Das kann aber nicht mithalten mit diesem Video hier. Zu einem PLoS One Paper von Yafetto et al. über Hochgeschwindigkeits-Videos der Sporenverteilung von Pilzen haben die Studenten der Gruppe ein Best Of zusammengestellt, untermalt mit Musik aus Verdis "Il trovatore". Unbedingt ansehen!
Adblock

[via The Loom]

Samstag, September 06, 2008

Paperverwaltung mit Mendeley, die zweite

Auf meinen ersten Post über Mendeley hat in den Kommentaren Victor, einer der Mitgründer von Mendeley, geantwortet. Wer einen kleinen Einblick in die Features der nächsten Versionen von Mendeley haben möchte, sollte mal einen Blick in die Kommentare werfen!

Der Bug mit der Autorenreihenfolge, den ich in dem Post beschrieben hatte, war übrigens schon nach wenigen Tagen in einem Update behoben!

Donnerstag, August 14, 2008

Was hat ein Brustkrebsgen mit der Entwicklung von Sprossachsen von Pflanzen zu tun?

Gute Frage. Die hab ich mir auch gestellt, als mir vor kurzem ein neues Paper von Pei Han und Kollegen in die Hände gefallen ist. Ich hab aber noch einen kleinen Vorsprung. Wahrscheinlich haben sich nämlich gerade die meisten eine noch grundlegendere Frage gestellt: Was hat denn bitte ein Brustkrebsgen generell in einer Pflanze zu suchen?!? Pflanzen kriegen keine Krebserkrankungen, Brustkrebs schon mal gar nicht!

Ich werd deshalb erst mal mit dem Brustkrebsgen loslegen. In etwa 10% aller Brustkrebserkrankungen können Mutationen im Gen BRCA1 (breast cancer gene 1) festgestellt werden. Betrachtet man nur erbliche Formen von Brustkrebs, ist der Anteil sogar noch größer [1]. Die Bezeichnung Brustkrebsgen ist aber eigentlich irreführend: Zwar wurde das Gen aufgrund seiner Häufung in erblich bedingtem Brustkrebs gefunden, und danach benannt. Mutationen in BRCA1 findet man aber auch häufig bei Krebserkrankungen der Eierstöcke, des Dickdarms und der Prostata. Tatsächlich ist BRCA1 also ein Gen, das die Zellen generell vor Schäden an der DNA schützt, die zu Krebs führen können, und das durch seinen Ausfall die Bildung von Tumoren begünstigt. Diese Definition trifft auf eine ganze Reihe von Genen zu, die man zusammenfassend als Tumorsuppressorgene bezeichnet.
BRCA1 ist deshalb so wichtig für die Integrität der Zelle, weil es eine sehr wichtige Aufgabe in der Reaktion der Zelle auf schwere Schäden an der DNA wahrnimmt. DNA-Doppelstrangbrüche (DSBs) sind eine Art von Schaden, die für die betroffene Zelle nur sehr schwer zu reparieren sind. BRCA1 ist an einem Weg zur Reparatur von DSBs beteiligt, der keine Mutationen erzeugt - der homologen Rekombination (HR). Es nimmt in diesem komplexen Durcheinander von Subwegen eine interessante Stellung ein, weil man es gleich in mehreren davon finden kann. Die Aufgabe von BRCA1 ist dabei wie es aussieht die eines Signalgebers: Es kann an verschiedene andere Proteine ein Signalmolekül anhängen, das kleine Protein Ubiquitin. Welche Proteine genau das Ziel von BRCA1 sind ist noch nicht geklärt, und auch nicht was die Folgen des Anfügens von Ubiquitin sind [2].
Soviel zu BRCA1, obwohl ich doch eigentlich über ein ganz anderes Protein schreiben will, BARD1. Das ist aber gar nicht so schlimm, denn BRCA1 und BARD1 (breast cancer associated RING domain) arbeiten zusammen in der Funktion, Ubituitine auf andere Proteine zu übertragen. Und weil man über BRCA1 mehr weiß und es bekannter ist, hab ich einfach damit angefangen.

Nachdem also geklärt ist, was über BRCA1 und BARD1 als Brustkrebsgen im Menschen so bekannt ist, springen wir in die Organismen, mit denen ich arbeite, den Pflanzen. Und die Frage, warum ein Brustkrebsgen in Pflanzen zu finden ist, kann nun auch leicht beantwortet werden: Auch wenn Pflanzen keinen Krebs bekommen können, müssen sie sich trotzdem vor Schäden an ihrer DNA schützen. Und die DNA-Reparatur ist so grundlegend, dass man fast alle der zentralen Proteine in den bisher untersuchten Organismen findet, auch in Pflanzen. So gibt es eben auch BRCA1 in Pflanzen [3]. Kollegen von unserem Institut konnten vor zwei Jahren zeigen, dass auch BARD1 in Pflanzen vorkommt, dass es zusammen mit BRCA1 arbeitet und dass es Regulationsfunktionen bei der DNA-Reparatur wahrnimmt (Reidt et al., 2006).

Machen wir nun mal einen kleinen Ausflug in Aufbau und Entwicklung von Pflanzen. Wie in Tieren findet man auch in Pflanzen Stammzellen, also undifferenzierte Zellen, aus denen verschiedenste Zelltypen hervorgehen. Sie sitzen in spezialisiertem Gewebe, von dem das Wachstum der Pflanze ausgeht, dem sog. Meristem. Meristeme gibt es demnach beispielsweise in der Wurzel- und Sprossspitze oder den Blüten. Das Sprossspitzenmeristem (shoot apical meristem, SAM) ist schon im Embryo der Pflanze zwischen den Keimblättern angelegt; aus ihm gehen alle pflanzlichen Organe über dem Boden hervor, also Sprossachse, Blätter, Blüten etc. Das SAM ist in mehreren Zonen organisiert, ganz im Zentrum davon liegen die undifferenzierten Stammzellen. Die Identität dieser Zonen wird durch komplexe Signalwege aufrechterhalten. So regulieren die 3 CLAVATA (CLV) Gene die Größe der Stammzellzone. CLV1 und 2 sind Rezeptoren, und CLV3 ein Ligand dieser Rezeptoren. Durch Bindung von CLV3 an CLV1/CLV2 wird eine Signalkette ausgelöst, die die Zellen außerhalb der Stammzellzone zur Differenzierung anregt. Dies geschieht indirekt über das Gen WUSCHEL (WUS). Das verhindert nämlich erst mal im ganzen Meristem die Differenzierung der Stammzellen. Da die CLV Gene aber die Aktivität von WUS außerhalb der Stammzellzone stören, kommt es dort dann zur Ausdifferenzierung der Zellen.

Und nach dieser doch recht langen Einleitung will ich dann doch auch endlich zu dem im ersten Satz angesprochenen Paper kommen. Pei Han und Kollegen haben nämlich bemerkt, dass in Arabidopsis-Pflanzen, in denen BARD1 ausgeschaltet wurde, Defekte im SAM auftreten - weil die WUS-Aktivität nicht mehr auf die Stammzellzone beschränkt ist. Und da sitzt man als Mensch der DNA-Reparatur und -Rekombination erst mal baff da. Nach allem, was wir bisher von BRCA1/BARD1 wussten (und zwar auch im Menschen), hat es eben damit zu tun: Schaden an der DNA, BRCA1/BARD1 werden aktiv und helfen bei der Reparatur, und dann ist wieder Ruhe. Dass jetzt eine grundlegende Funktion in der Entwicklung von Pflanzen dazu kommt ist dann doch etwas überraschend [4].

Wachstum von Arabidopsis-Pflanzen, Wildtyp (links) und bard1-Mutante (rechts).
obere Zeile: 3 Wochen alte Pflanzen im Vergleich, Wildtyp links (I) und bard1-Mutante rechts (K)
untere Zeile: Dünnschnitte durch das SAM drei Wochen alter Pflanzen, ebenfalls wieder Wildtyp links (J) und bard1-Mutante rechts (L)
Die Bilder stammen aus Abbildung 1 von Han et al. (2008).
In der Abbildung oben kann man gut sehen, dass die Mutantenlinie, in der BARD1 ausgeschaltet wurde, ein ziemliches Problem im Wachstum hat. Und auch das SAM ist nicht so ausgebildet, wie man es aus dem Wildtyp gewohnt ist. Die Forscher konnten auch zeigen, dass die Expression von WUS, das normalerweise auf die Stammzellzone beschränkt ist, in der bard1-Mutante nur noch in den äußersten Zellschichten des SAM zu finden ist.
Lokalisation der WUS mRNA im SAM. In Wildtyp-Pflanzen ist WUS nur im Zentrum des SAM, in der Stammzellzone, zu finden (B), in der bard1-Mutante jedoch ausschließlich in den äußeren Bereichen und nicht mehr in der Stammzellzone (D).
Die Bilder stammen aus Abbildung 1 von Han et al. (2008).
Durch weitere Untersuchungen konnte gezeigt werden, dass BARD1 an einer bestimmten Stelle im Promotor von WUS bindet. Im Promotor von Genen befinden sich regulatorische Sequenzen, an die Proteine wie Transkriptionsfaktoren binden und die Aktivität des Gens (also die Menge an hergestellter mRNA) regulieren. Das erwartet man aber nicht von einem Protein wie BARD1, das Ubiquitine auf andere Proteine überträgt.
Die Gruppe hat natürlich auch mehrere Kontrollexperimente durchgeführt, um diese Beobachtungen abzusichern. So ergab auch die Verwendung von RNAi gegen BARD1 als alternativer Methode zum Ausschalten eines Gens ähnliche Ergebnisse. Kreuzten sie wus-Mutanten mit der bard1-Mutante, so traten Defekte wie in der ersten Abbildung gezeigt nicht mehr auf. Und, je mehr BARD1-Protein in der Zelle vorhanden ist, desto weniger des WUS-Gens findet sich. Es kann also als gesichert gelten, dass der beobachtete Effekt wirklich auf BARD1 und WUS zurückzuführen ist.
Aber wie, und warum? Dazu können die Autoren bisher erst Vermutungen liefern. Leider haben sie nicht überprüft, ob BARD1 am WUS-Promotor tatsächlich wie ein Transkriptionsfaktor wirkt und direkt die Herstellung der mRNA reguliert. Sie vermuten eher, dass der Teil des Chromosoms, auf dem das WUS-Gen liegt, eine sehr komprimierte Form einnimmt, was die Transkription hindert. Da ein Protein namens SYD, das den Komprimierungsgrad von DNA reguliert, sowohl an der gleichen Stelle wie BARD1 an den WUS-Promotor bindet, als auch direkt mit BARD1 interagiert, scheint BARD1 wohl auch mit der Regulation der Chromosomenstruktur zu tun zu haben.

So, langer Post (ich glaube mein bisher längster) über ein für mich sehr überraschendes Paper. Auch wenn es für euch wahrscheinlich nicht so überraschend war, habe ich auf diese Weise aber auch gleich über das wichtige Thema BRCA1/BARD1 schreiben können, was ich sowieso demnächst gemacht hätte. Und über das SAM und wie es reguliert ist habe ich nebenbei auch noch etwas gelernt!

[1] Das Risiko für Frauen, die erblich bedingt Mutationen in BRCA1 besitzen, während ihrer Lebenszeit an Brustkrebs zu erkranken, liegt je nach Quelle (OMIM, DKFZ) bei 80-92%.
[2] Normalerweise ist das Anfügen von langen Ketten von Ubiquitin an Proteine ein Abbausignal für die Zelle. Die so markierten Proteine werden in einem großen Proteinkomplex, dem Proteasom, zu kleinen Fetzen geshreddert. Gerade im Bereich der DNA-Reparatur wurden aber schon ein paar Proteine gefunden, die nur einige wenige Ubiquitine angehängt bekommen statt einer langen Kette. In dem Fall verändern sich die Eigenschaften des Proteins, und es wird nicht abgebaut.
[3] Wenn ich hier von Pflanzen spreche, dann meine ich eigentlich den Modellorganismus für Pflanzen, die Ackerschmalwand Arabidopsis thaliana. Wie es bei den restlichen Pflanzen mit BRCA1 aussieht weiß ich nicht, die sinnvollste Vermutung ist aber erst mal, dass es bei denen auch vorkommt.
[4] Natürlich gibt es auch Mutanten der DNA-Reparatur, die Wachstumsstörungen des Organismus zur Folge haben. Das hängt aber damit zusammen, dass während der Zellteilung Probleme auftreten können die repariert werden müssen. Das ist aber hier nicht der Fall, es geht um die Aktivität eines anderen Gens!

P. Han, Q. Li, Y.-X. Zhu (2008). Mutation of Arabidopsis BARD1 Causes Meristem Defects by Failing to Confine WUSCHEL Expression to the Organizing Center THE PLANT CELL ONLINE, 20 (6), 1482-1493 DOI: 10.1105/tpc.108.058867
Wim Reidt, Rebecca Wurz, Kristina Wanieck, Hoang Ha Chu, Holger Puchta (2006). A homologue of the breast cancer-associated gene BARD1 is involved in DNA repair in plants The EMBO Journal, 25 (18), 4326-4337 DOI: 10.1038/sj.emboj.7601313
Übrigens: beide Paper sind frei erhältlich - Hurra für Open Access!

Montag, August 11, 2008

Paperverwaltung mit Mendeley

Wollte ein Wissenschaftler bisher seine Sammlung an Literatur verwalten, hatte er recht wenige Möglichkeiten, das mit Software zu tun. Klar, man kann das per Hand erledigen, indem man z.B. Ordner mit den PDFs auf dem Rechner anlegt, und dann Listen z.B. in Excel hat, wo welches Paper liegt. Das ist aber nicht sehr praktisch und erfordert jede Menge Tipperei. Also nimmt man besser eine Software dafür, die die Literaturdaten über Onlinedatenbanken herunterlädt und eine übersichtliche Organisation bietet. Da hat man als Wissenschaftler aber leider eine sehr kleine Auswahl. Im Grunde bleiben da nur kommerzielle Programme wie EndNote (die aber sehr teuer sind), oder Zotero, das als Firefox-Erweiterung kostenlos arbeitet, dafür aber ziemlich unkomfortabel ist.
Die Mac-Gemeinde hat seit ein paar Monaten nun mit Papers eine sehr gute Software zur Hand, wie man so hört. Ich hab keinen Mac und kann deshalb nur die überschäumenden Blogposts lesen und neidisch sein.

Seit ein paar Tagen gibt es nun aber mit Mendeley Konkurrenz zu Papers, die dazu noch auf allen Plattformen läuft. Und Mendeley kann sogar als public beta noch einiges mehr: Die eigentliche Paperverwaltung ist sehr einfach und intuitiv gestaltet. Man kann neue Einträge von Hand anlegen oder aus anderen Programmen wie EndNote importieren. Hat man einen DOI zum Paper, dann kann man die Informationen auch über CrossRef vervollständigen lassen. Neu gegenüber Programmen wie EndNote und Zotero ist die Integration der PDFs in der Datenbank: Zu jedem Eintrag kann man eine Verknüpfung zur PDF Datei des Papers auf der Platte anlegen, und ein integrierter PDF-Viewer zeigt das Paper dann auch in Mendeley an. Außerdem hat man auch die Möglichkeit, seine Literatur in Dokumentengruppen zu ordnen und einzelnen Papern Tags und Notizen anzuheften.
Die Integration der PDFs geht aber noch weiter! Bei Text-PDFs (und in Zukunft dann auch bei eingescannten PDFs durch OCR) versucht Mendeley die Metainformationen auszulesen. Auch hier ist es natürlich am besten, wenn der Journal DOIs abdruckt. Im Prinzip hat man so eine einfache Variante, eine bestehende Sammlung in Mendeley einzupflegen - man wirft einfach per drag and drop seinen Literaturordner rein, und Mendeley liest alle PDFs aus und stellt Verknüfungen zu den Dateien her. Sehr praktisch! Der Nachteil dieser Methode ist zur Zeit noch, dass der Algorithmus zum Auslesen von Metainformationen in Mendeley alles andere als perfekt ist. Man muss eigentlich jeden Eintrag nachbessern. Doch die Mendeley-Macher versprechen, dass der Algorithmus mit der Zeit immer besser werden wird. Die automatischen Auswertungen werden samt den manuellen Verbesserungen anonymisiert zum Hersteller übertragen, so dass Anpassungen vorgenommen werden können. Noch eine Funktion mit der Auswertung von Metadaten aus PDFs: Die Literaturliste am Ende von Papern wird ebenfalls extrahiert und kann gesondert eingesehen werden.
Jetzt haben wir also eine schöne Sammlung unserer Literatur, die alles übertrifft, was ich bisher kannte. Es gibt neben der Desktopkomponente aber auch noch weitere Funktionen online. Man kann sich bei Mendeley eine Profilseite anlegen, die ähnlich gestaltet ist wie die von Sozialnetzwerken [1]. Aus Mendeley Desktop kann man nun seine Literaturlisten hochladen, so dass man von überall darauf Zugriff hat. Besser noch, man kann die verknüpften PDFs mit hochladen, und kann dadurch auch von zuhause mal einen Blick in ein Paper werfen, das hinter Zugriffsbeschränkungen von Journals liegt [2]. Und ich konnte noch keine Platzbeschränkung für die PDFs finden...ob die Macher sich das genau überlegt haben? [3]
Und schließlich kann man sich mit anderen Mendeley-Nutzern auch in Gruppen zusammenschließen und innerhalb der Gruppen Literatur austauschen. Das hab ich aber noch nicht ausprobiert und kann deshalb nichts dazu sagen.

Nach diesem überschwenglichen Lob sind jetzt aber auch noch einige Kritikpunkte fällig. Größter darunter: Nachdem ich meine Literaturliste mit über 1000 Einträgen importiert hatte, wurde Mendeley sehr langsam. Wirklich sehr sehr langsam. Ich hoffe, dass die Performance mit den kommenden Updates verbessert wird! Will man einen PDF-Link anlegen, dann startet man zur Zeit jedes mal im Installationsverzeichnis von Mendeley und muss zu den PDFs navigieren. Ziemlich lästig, und das werde ich mit meinen vielen Papern sicher nicht machen. Aber ein feature request ist schon abgeschickt, dass man sich mit einer kommenden Version dann ein anderes Verzeichnis wählen kann. Außerdem ist mir aufgefallen, dass Mendeley bei einigen wenigen Einträgen die Reihenfolge der Autoren umstellt. Bisher konnte ich keinen Zusammenhang zwischen den betroffenen Papern feststellen, und die neue Reihenfolge ist auch nicht alphabetisch oder so. Ändert man die Reihenfolge, dann stellt sie Mendeley gleich wieder um. Aber auch hier ist ein Bugreport schon abgeschickt. Schließlich fehlt mir noch eine Funktion, die wohl nicht so schnell eingebaut werden wird: Man kann die Literaturliste leider nicht beim Schreiben von Texten verwenden, wie es professionelle Programme erlauben. Solange ich auf EndNote angewiesen bin, um Literaturverweise in eigenen Texten einzufügen und zu formatieren brauche ich Mendeley eigentlich nicht doppelt einsetzen.

Zusammenfassend halte ich Mendeley für ein äußert vielversprechendes Programm, und es lohnt sich wirklich für jeden Wissenschaftler, mal reinzuschauen. Doch solange noch grundlegende Probleme das Benutzen des Programms erschweren werde ich nicht komplett darauf umsteigen. Mal sehen was sich noch alles tut, bis Mendeley aus dem Betastatus herauswächst!

[1] Ich mache hier noch einmal Werbung für das Wissenschaftlernetz SciLink, das ist echt klasse!
[2] Und das ist nicht öffentlich, was aus Copyrightgründen sicher sinnvoll ist...
[3] Nicht dass mich das stören würde. Meine Paper belegen jedenfalls schon über 1 GB auf der Platte.

Sonntag, August 10, 2008

DNA-Strukturen II: Haarnadeln

Die Idee, diesen Post mit einem Frisurenwitz zu beginnen, hab ich dann doch sein gelassen. Aber es stimmt wirklich: DNA kann Strukturen ausbilden, die wie Haarnadeln (oder halt auf engl. hairpins) aussehen. Der Grund dafür ist eigentlich ein simpler. Die Grundregeln der Paarung von Nukleotiden, also die Watson-Crick Basenpaarung (A-T und C-G), gilt nicht nur dann, wenn sich zwei Stränge von DNA aneinander lagern. Das klappt problemlos auch innerhalb eines Strangs, sofern es die Nukleotidsequenz zulässt.

Ein klassisches Beispiel sind hier die direct repeats. Eigentlich kann sich jeder gut vorstellen, wie so etwas aussehen muss. Wir nehmen eine bestimmte DNA-Sequenz (z.B. ACGT) und wiederholen sie ein- bis mehrmals, auch mit ein wenig Abstand dazwischen. In dem Fall ist es für die DNA möglich, Basenpaarungen innerhalb eines Strangs auszubilden.
Abbildung aus Dhar und Lahue, 2008

Die daraus entstehende Struktur sieht wie eine Haarnadel aus: Die beiden gepaarten Teile eines DNA-Strangs stehen aus der Ebene des Doppelstrangs heraus; liegt zwischen den wiederholten Sequenzen noch ein nicht wiederholter Bereich DNA, so bildet der eine Schleife (loop) aus ungepaarten Nukleotiden.

Solche Haarnadelstrukturen stellen für Zellen ein großes Problem dar. Weil die hairpins wie gesagt aus der Ebene des DNA-Doppelstrangs herausstehen, behindert dies viele DNA-bindende Proteine. Um mal mit etwas eher positivem anzufangen will ich erst ein Beispiel bringen, wie dieses Problem auch vorteilhaft ausgenutzt werden kann. Während der Transkription bildet die Zelle eine Abschrift eines Gens in Form von mRNA. Dazu muss aber der Komplex aus Proteinen, der die Transkription bewerkstelligt, genau wissen wo auf der DNA er anzufangen und aufzuhören hat. Und beim Beenden der Translation kommen zumindest in einigen Fällen die repeats ins Spiel: Im Modellbakterium E. coli besitzen manche Gene an ihrem Ende Terminatorsequenzen, in denen Sequenzen wiederholt werden. Erreicht die Transkriptionsmaschinerie diesen Terminator, dann bildet die neu hergestellte mRNA einen hairpin aus, der die Proteine von der DNA abfallen lässt - die Transkription ist beendet.

Im Allgemeinen sieht es aber nicht so rosig für die Zelle aus, was Haarnadelstrukturen angeht. Die Probleme beginnen schon viel früher als in der Transkription, wo die hairpins selbstverständlich stören, wenn sie nicht zufällig im Terminator liegen. Es ist nämlich schon schwer für die Zelle, die DNA während der Replikation über solche Bereiche hinweg zu kopieren. Deshalb gibt es auch einige Proteine, die spezifisch Haarnadelstrukturen erkennen und auflösen können.
Ein sehr berühmter (berüchtigter?) Fall ist die Krankheit Chorea Huntington (oder Huntington's Disease), eine erst spät im Leben einsetzende neurodegenerative Erbkrankheit. Da Nervenzellen im Gehirn ihre Funktion verlieren und absterben, leiden Erkrankte sowohl unter psychischen und kognitiven Beschwerden, als auch immer stärker eingeschränkter Bewegungsfähigkeit, bis sie nach mehreren Jahren sterben. Bisher ist keine Möglichkeit bekannt, die Krankheit aufzuhalten oder zu heilen.
Nach langem Suchen wurde die Ursache für diese Krankheit im Gen Huntigtin in einer Abfolge von von CAGs gefunden. In gesunden Menschen wird das CAG nicht mehr als 35 mal wiederholt. Sieht man sich diesen Bereich jedoch in Erkrankten an, dann findet man bis zu 250 CAG-Wiederholungen! Mehr noch, diese Krankheit kann vererbt werden, und in der Regel verlängert sich die CAG-Kette mit den Generationen. Wie kommt diese Verlängerung zustande? Die DNA-Polymerase, die während der Replikation die DNA-Stränge kopiert, verliert bei so langen Wiederholungen immer gleicher Basen irgendwann die Übersicht, wie viel sie denn eigentlich schon produziert hat. Schuld daran ist wahrscheinlich, dass sie auf dem CAG-Bereich hin- und herrutscht (replication slippage), und dass währenddessen die DNA hairpins ausbilden kann. So kann mit jeder Zellteilung die CAG-Kette länger werden. Wieso kann eine Verlängerung der CAG-Folge eine solche Krankheit auslösen? Dazu muss man wissen, dass die Information, in welcher Abfolge Aminosäuren zu Proteinen zusammengebaut werden, in der DNA als Nukleotidtripletts kodiert sind. Bei der Herstellung von Proteinen wird immer drei Nukleotide abgelesen und in eine Aminosäure "übersetzt", die dann mit der vorigen verknüpft wird (Translation). Aha! Drei Nukleotide gleich eine Aminosäure, und Schuld ist eine Wiederholung der drei Nukleotide CAG! Genau, die CAG-Wiederholungen auf DNA-Ebene entsprechen Wiederholungen der Aminosäure Glutamin. Es ist noch nicht genau geklärt, wieso genau eine lange Glutaminkette im Huntingtin-Protein zu all den beschriebenen Problemen führt, aber mögliche Schuldige sind ein schlechterer Abbau des Proteins, die Bildung von großen Proteinklumpen durch Zusammenlagerung über die Glutamine, oder toxische Eigenschaften des veränderten Proteins.
Neben Chorea Huntington sind noch weitere Krankheiten bekannt, die alle auf die Verlängerung von Wiederholungen von drei Nukleotiden zurückzuführen sind.

Abbildung aus Daee et al., 2007
In der Abbildung sind Möglichkeiten gezeigt, wie Trinukleotidrepeats verlängert werden können. Beschrieben habe ich die in B gezeigte Variante, replication slippage. Speziell bei Trinukleotidrepeats scheint die Helikase SRS2 eine wichtige Rolle in der Längenregulation zu spielen, indem sie hairpins entwindet. [1]

Zum Abschluss will ich noch ein wenig Abstand von Krankheiten und Haarnadeln nehmen und einen globaleren Blick auf das Genom werfen. Wenn diese repeats so schlecht für die Zelle sind, wieso gibt es sie dann überhaupt? Interessanterweise sind Nukleotidwiederholungen im menschlichen Genom [2] nicht gleich of vorhanden. Wiederholungen einzelner Nukleotide beispielsweise unterscheiden sich um den Faktor 150 in ihrem Auftreten [4]! Ähnlich ist es auch bei Di- und Trinukleotidwiederholungen. Doch nicht nur der Anteil von repeats ist nicht-zufällig, auch die Position dieser repeats im Genom. Innerhalb der kodierenden Bereiche von Genen finden sich signifikant weniger repeats aller Arten als außerhalb davon. Interessanterweise finden sich (in Pflanzen, wie es in anderen Organismen aussieht weiß ich nicht) die repeats aber häufiger in nichtkodierenden Bereichen von Genen als im Rest des Genoms. Das heißt, dass die Wiederholungen vor allem in den regulatorischen Bereichen vor und hinter den proteinkodierenden Teilen eines Gens angereichert sind. Da ein Vergleich der Verteilung von repeats in verschiedenen Pflanzengenomen ein ähnliches Muster ergab, und speziell die Wiederholungen in den regulatorischen Regionen zwischen vielen Pflanzen über Millionen von Jahren unverändert blieben, scheinen sie wohl eine regulatorische Funktion zu besitzen. Wie die aussieht ist noch niemandem klar; es ist aber nicht dumm zu vermuten, dass die Ausbildung von Haarnadelstrukturen den Zugang von Proteinen zu den Genen beeinflussen kann.

Die Abbildungen konnte ich übrigens verwenden, weil die Arbeiten in Open Access Zeitschriften veröffentlicht wurden. Ich werde auch weiterhin keine Abbildungen verwenden, die nicht unter einer freien Lizenz stehen. Schade für die vielen geschlosenen Journals. Aber es bessert sich ja so langsam!

[1] über SRS2 sicher demnächst noch mehr, und nicht nur weil ich zufällig damit arbeite :-]
[2] in anderen Genomen auch, ich habe fürs menschliche aber gerade Zahlen [3]
[3] die Daten sind aus Stewart Scherers "A short guide to the Human Genome", über das ich in den nächsten Tagen auch noch schreiben will
[4] A oder T: 27369; C oder G: 187

Dhar A und Lahue RS (2008): Rapid unwinding of triplet repeat hairpins by Srs2 helicase of Saccharomyces cerevisiae. Nucleic Acids Research 36(10):3366-3373.
Daee DL et al. (2007): Postreplication Repair Inhibits CAG · CTG Repeat Expansions in
Saccharomyces cerevisiae. Molecular and Cellular Biology 27(1):102-110.
Morgante M et al. (2002): Microsatellites are preferentially associated with nonrepetitive DNA in plant genomes. Nature Genetics 30:194-200.
Zhang L et al. (2006): Conservation of noncoding microsatellites in plants: implications for gene regulation. BMC Genomics 7:323.